El archivo llega como un JPEG. Una captura de pantalla de teléfono de un extracto bancario, recortada a la página, ligeramente inclinada. Sin producer string. Sin fuentes. Sin historial de revisiones. Sin content stream. Solo un rectángulo plano de píxeles.
Hace unos meses escribimos un artículo extenso sobre lo que un PDF no puede ocultar: los marcadores del editor, las tablas de fuentes, los guardados incrementales que conservan el propio historial de edición de un archivo. Todo cierto. Todo desaparecido aquí. A este archivo no le queda nada que ocultar, porque quien lo hizo desechó la estructura del archivo.
Cuando el archivo deja de hablar, el documento aún tiene que hacerlo.
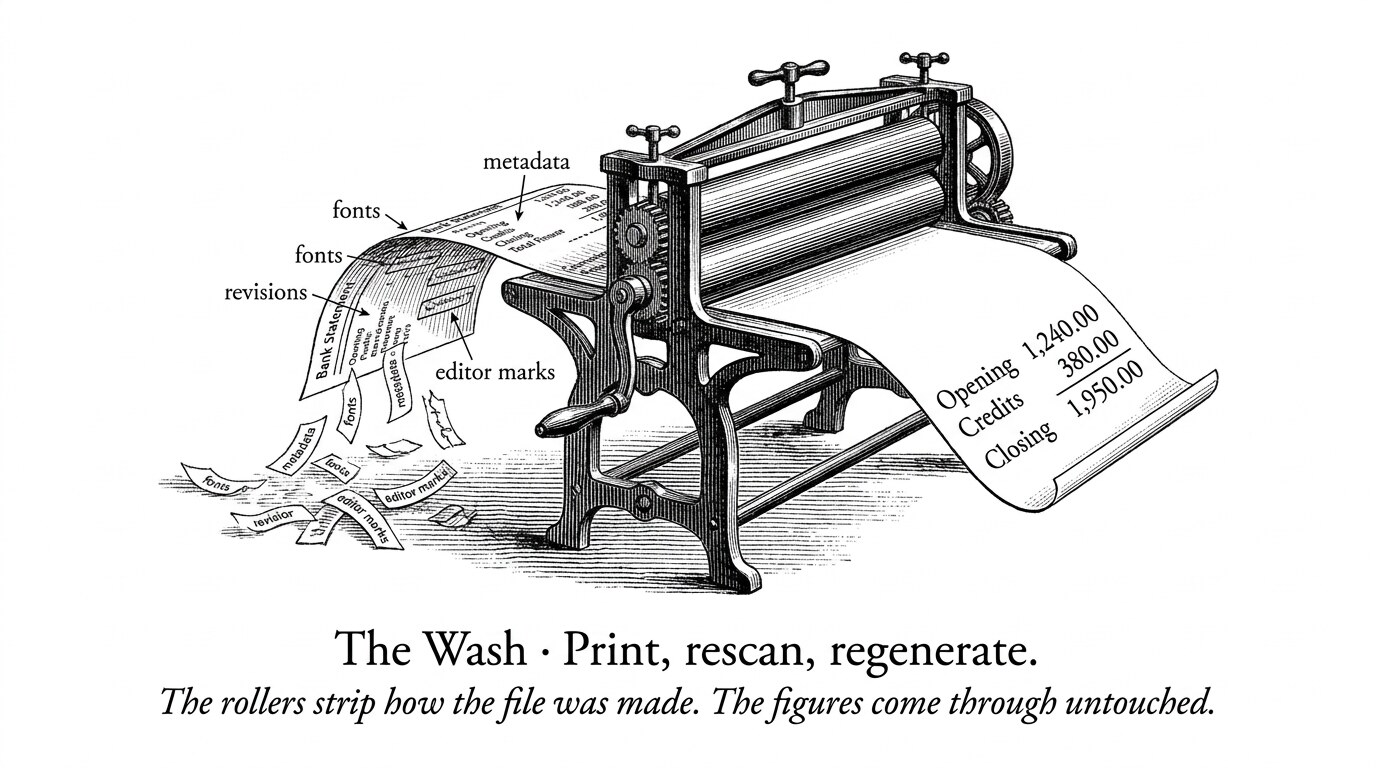
Tres formas de lavar un documento
El análisis forense estructural tiene un punto ciego que todo falsificador serio ha encontrado: inspecciona el contenedor del archivo, y el contenedor es opcional.
Hay tres formas comunes de desecharlo.
- Imprimir y volver a escanear. La edición ocurre en un editor de PDF, el resultado pasa por una impresora y un escáner, y lo que sale es un escaneo honesto de una página deshonesta. Todo rastro estructural se queda en la primera computadora.
- Regenerar. Entregar la página a un modelo de imagen con "cambia el saldo de cierre a 4.820,00". Devuelve una nueva imagen. No un archivo editado: uno nuevo, sin ningún historial en absoluto.
- Saltar de formato. Exportar a PDF, tomar una captura de pantalla, enviar la captura, dejar que el sistema receptor lo vuelva a empaquetar en un PDF. Cada conversión lava un poco más.
Lo que sale en el lavado
El mismo extracto falsificado, entregado de cuatro formas. La evidencia sobre cómo se hizo el archivo desaparece. Lo que el documento afirma pasa intacto.
| Evidencia | PDF editado | Impresión y escaneo | Regenerado por IA | Salto por captura |
|---|---|---|---|---|
| Cómo se hizo el archivo | ||||
| Marcadores del editor en la página | presente | desaparecido | desaparecido | desaparecido |
| Fuentes, revisiones, historial de objetos | presente | desaparecido | desaparecido | desaparecido |
| Productor y metadatos | presente | del escáner | desaparecido | del conversor |
| Lo que el documento afirma | ||||
| Saldos, totales, sumas acumuladas | intacto | intacto | intacto | intacto |
| Dígitos de control IBAN y RIB | intacto | intacto | intacto | intacto |
| Sello 2D-Doc firmado por el emisor | intacto | intacto | redibujado | intacto |
| Identidad visual del emisor | intacto | intacto | intacto | intacto |
Un detector que solo lee el archivo se queda con dos malas opciones cuando llega un escaneo. Para el archivo, todos los escaneos se ven iguales: un nuevo productor, sin fuentes, una imagen por página, editada o no. Así que, o trata cada escaneo como sospechoso, y los analistas aprenden a ignorarlo, o deja pasar todos los escaneos, y los falsificadores aprenden a imprimir.
De cualquier manera, está juzgando al escáner, no la edición.
Lo que sobrevive al lavado
Aquí está lo que un falsificador no puede lavar: las afirmaciones.
Un extracto bancario afirma un saldo inicial, una lista de transacciones, un saldo de cierre y un período de facturación. Afirma un IBAN cuyos dígitos de control se calculan a partir del resto. Afirma provenir de un banco específico, con el encabezado y diseño de ese banco. Un aviso de impuestos francés puede llevar un sello que la administración emisora firmó con su clave privada.
Imprimir no borra nada de eso. Pasar la página por un modelo de imagen tampoco lo borra: solo convierte la coherencia en un problema del falsificador. Así que la pregunta se invierte. No es "¿cómo se hizo este archivo?" sino "¿puede este documento ser verdadero?"
Ese cambio nos obligó a modificar cómo sopesamos la evidencia. Hoy, cada una de nuestras 92 señales pertenece a uno de cuatro niveles, y el nivel decide lo que una señal puede hacerle a un veredicto.
No toda la evidencia tiene permitido condenar
El nivel de una señal, no su recuento, decide lo que puede hacerle a un veredicto. Veintitantas anomalías siguen sumando solo un "vale la pena revisar".
El análisis forense estructural vive principalmente en los dos niveles intermedios. El lavado destruye ambos. Las contradicciones son la evidencia que sobrevive al lavado, así que ahí es donde indagamos.
Aritmética, al centavo
Una ecuación de saldo es la comprobación más antigua del manual: saldo inicial, más créditos, menos débitos, igual a saldo de cierre. Todos dicen que lo hacen. Los detalles deciden si funciona o te miente.
La tolerancia. Nuestro pipeline de extracción concilia los saldos con una tolerancia de 0,02 €, porque un modelo que lee un escaneo ruidoso ocasionalmente perderá un centavo y no queremos rechazar un extracto honesto por ello. El control de fraude usa 0,005 €. Dos ediciones de un centavo mueven un saldo exactamente 0,02 €, y un falsificador que conoce tu tolerancia sabe cuánto puede robar por fila.
Más de una ecuación. Un extracto imprime la misma verdad varias veces. La fila de totales tiene que ser igual a la suma de las filas. El resumen del encabezado tiene que ser igual a los totales. Un saldo intermedio impreso a mitad de la tabla (una línea de fin de mes "SOLDE AU 30/11") tiene que coincidir con el total acumulado en esa línea exacta. Cambia una transacción, y un falsificador ahora tiene cuatro números que reparar en lugar de uno.
El falsificador arregló el saldo de cierre. Otras tres ecuaciones aún no cuadran.
Un crédito de salario aumentado en 1.000 €, y el saldo de cierre aumentado para coincidir, por lo que el clásico control de saldo pasa. El extracto imprime la misma verdad en tres lugares más, y nadie los arregló.
| Fecha · concepto | Débito | Crédito | Saldo |
|---|---|---|---|
| 01/10 · Saldo inicial | 2,104.30 | ||
| 02/10 · Salario, ACME SAS | 2,480.00editado | ||
| 05/10 · Alquiler | 850.00 | ||
| Saldo al 15/10 | 2,734.30 | ||
| 18/10 · Pagos con tarjeta | 127.45 | ||
| 24/10 · Transferencia recibida | 300.00 | ||
| Totales | 977.45 | 1,780.00 | |
| 31/10 · Saldo de cierre | 3,906.85también editado |
Fechas e identificadores. Cada transacción debe situarse dentro del período impreso. Un período no debería terminar antes de empezar. Un IBAN lleva una suma de comprobación MOD-97, y uno francés también lleva una clave RIB. Cambia un dígito y ambos se rompen, a menos que el falsificador los recalcule.
Esto es lo que pasó cuando falsificamos extractos nativos digitales en el mismo lugar (misma fuente, guardado limpio, sin ningún rastro estructural) y los ejecutamos con estos controles apagados, y luego encendidos:
Ediciones que el archivo no puede ver, atrapadas por la página
Cada una de estas ediciones deja el PDF estructuralmente limpio. Antes de los controles de contenido, las cuatro fueron atrapadas 0 veces.
Cero antes, porque estas ediciones se guardaron limpiamente, en el mismo lugar, con la misma fuente. El archivo no tenía nada que decir sobre ellas. La página sí.
Las cicatrices
Dos cosas que aprendimos por las malas.
Nunca confíes en un año que inferiste. Muchos extractos imprimen "31.10" sin año, y todo parser lo adivina. En los extractos genuinos de un banco, nuestro parser ponía fechas de valor exactamente un año antes cada vez que una transacción cruzaba el límite de un mes: 364 días de error, en cada muestra. Un control de fecha que confiara en esa suposición habría marcado a cada cliente honesto de ese banco. Una fecha solo cuenta como evidencia cuando el banco imprimió su año.
Un control de coherencia es una afirmación tanto sobre tu lector como sobre el documento. Cuando ejecutamos por primera vez el control de saldo en extractos de producción sin procesar, se activó en el 19% de ellos. Eso no era una ola de fraude. Era nuestro parser leyendo mal las filas, típicamente encontrando una fila sin su importe. Una contradicción aritmética solo es evidencia si estás seguro de que leíste bien los números. Así que el control se ejecuta solo donde leemos el propio texto del PDF directamente, en páginas nativas digitales, sin OCR de por medio. Y por sí solo genera una advertencia, no un veredicto.
No necesitas un falsificador para fallar un control de saldo. Solo necesitas un error en el parser.
El texto que dice una cosa y dibuja otra
Hay una trampa en "leer el propio texto del PDF directamente". Un falsificador que sabe que confiamos en el texto nativo digital puede saltarse el lavado por completo y mentirle al parser en su lugar. Todo pipeline de extracción lee la capa de texto, el nuestro y el de cualquier LLM incluidos, lo que convierte a la propia capa de texto en una superficie de ataque.
Un PDF puede adjuntar un reemplazo /ActualText a una secuencia de glifos, dibujando una cifra en pantalla mientras alimenta con otra a cada extractor de texto. El mapa /ToUnicode de una fuente puede ser reconfigurado para que la forma sea un 7 y el texto copiado sea un 1. El analista humano ve un extracto. El control de saldo automatizado valida otro. Ambos pasan, porque están leyendo dos documentos diferentes.
Una página, dos documentos
Los glifos y la capa de texto son cosas separadas en un PDF. Nada los obliga a coincidir.
BT /F1 11 Tf 412 318 Td
/Span << /ActualText (1,450.00) >> BDC
  (9,450.00) Tj            % the glyphs a human sees
EMC
ETAsí que dejamos de confiar en la capa de texto para los números. Tomamos cada dígito que una fuente afirma dibujar, lo renderizamos solo, lo volvemos a leer con OCR y lo comparamos con la capa de texto. En nuestro benchmark esto atrapó 101 de 101 intercambios de /ActualText, con cero falsos positivos en 208 archivos genuinos.
Nos encontramos con una versión más cruda de la misma idea en producción, en un extracto que afirmaba provenir de un importante banco francés. El falsificador no se molestó en borrar las transacciones originales: dibujó rectángulos blancos opacos sobre las filas y escribió nuevas cifras encima, 48,00 situado directamente sobre 162,00. En ese momento, nuestro motor lo calificó como normal. Hoy verificamos el orden de dibujo para importes enterrados bajo un relleno opaco posterior con nuevo texto dibujado sobre ellos, y lo califica como de alto riesgo. (El control necesita ambas mitades. Un relleno blanco por sí solo se activó en 13 archivos genuinos, porque algunos controladores de impresión sombrean las celdas de la tabla después de dibujar el texto).
Si tu control de fraude y tu extractor leen la misma capa de texto, un falsificador solo tiene que engañarlo una vez.
La criptografía sobrevive al escáner
Cada control hasta ahora pregunta si el documento concuerda consigo mismo. Un falsificador cuidadoso puede ganar ese juego. Si cambian una transacción y luego actualizan cuidadosamente la fila de totales, el resumen del encabezado y el saldo acumulado, la aritmética por sí sola no los atrapará.
Algunos documentos llevan un control que ninguna cantidad de cuidado puede vencer. Las administraciones y servicios públicos franceses imprimen un 2D-Doc: un código de barras Data Matrix que contiene los campos clave del documento (nombre, dirección, importes de impuestos, período de referencia), firmado con la clave privada del emisor bajo el estándar ANTS.
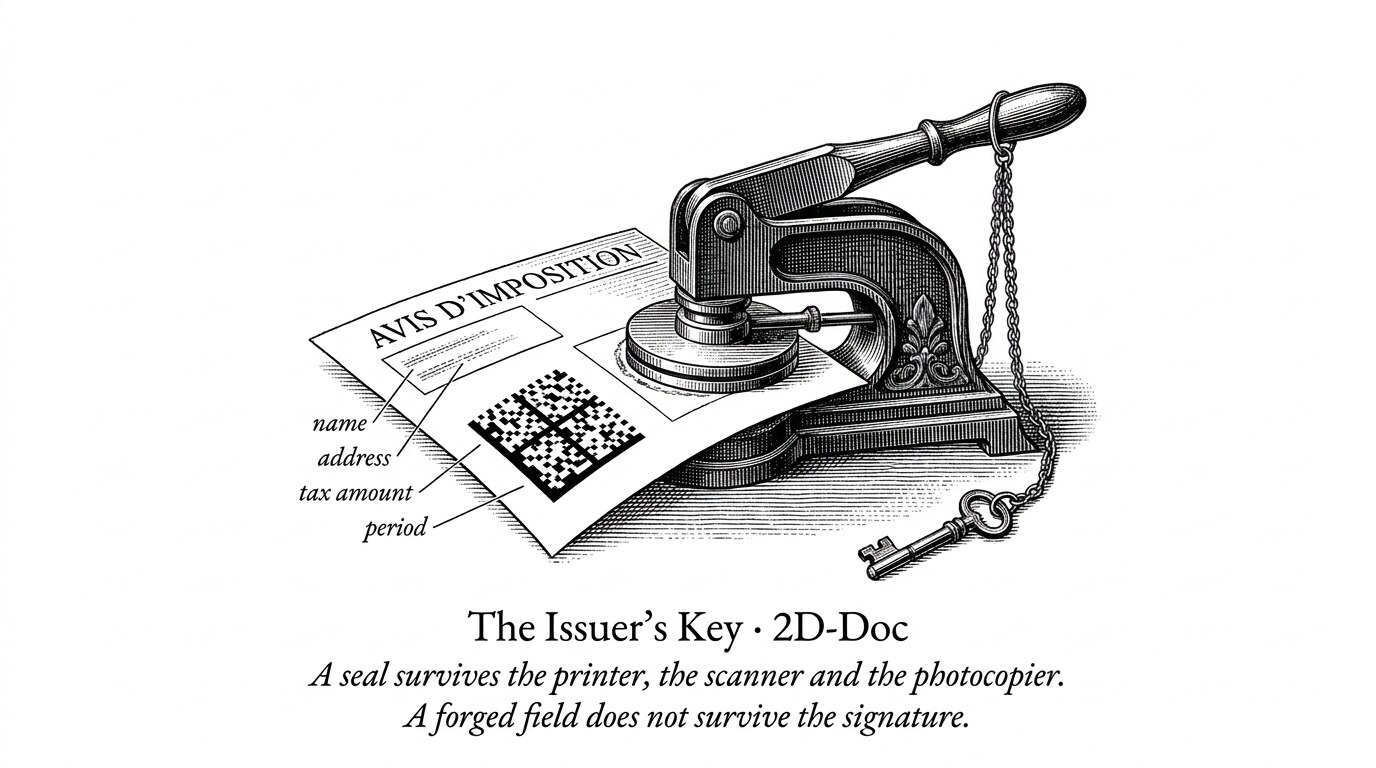
El sello tiene una propiedad que la evidencia estructural nunca tuvo: sobrevive al lavado. Un código de barras se imprime y se vuelve a escanear perfectamente bien.
Comprobando un documento contra su emisor, no contra sí mismo
El sello se lee de los píxeles, por lo que funciona en un escaneo, una foto o una impresión de una impresión.
Ese último caso provino de un grupo de avisos de impuestos creados con un kit de autoedición. El código de barras se veía bien. Alguien dibujó una imagen de un sello, esperando que nadie lo escaneara.
El control de coherencia más fuerte no es que el documento concuerde consigo mismo. Es que el documento concuerde con la clave de su emisor.
¿Se ve como quien dice ser?
La falsificación más barata no toca los números. Toma un extracto genuino de un banco pequeño y pega el encabezado de un banco grande encima.
Los números son honestos. Solo el membrete miente. Así que comparamos la página, parche por parche, contra páginas de referencia verificadas para cada familia de bancos y preguntamos a cuál se parece realmente. Cuando el banco que nombra y el banco al que se parece difieren por un margen claro, marcamos la discrepancia.
En un conjunto de prueba reservado, esto atrapó el 75% de las falsificaciones de intercambio de encabezado mientras se activaba en solo 1 de 213 documentos genuinos. Ese único falso positivo es instructivo: un archivo cuya primera página era la contraportada del banco, que no se parece al encabezado de nadie.
Y sí, los píxeles
Nada de esto significa que ignoremos la imagen. Cuando un documento es regenerado por un modelo de imagen, los píxeles son el único lugar donde el modelo deja una firma.
Los detectores genéricos de imágenes de IA están entrenados con fotos, y los documentos no son fotos. Probamos uno en páginas de documentos regeneradas por IA, en un umbral que marca solo el 1% de los documentos genuinos (medido en unas 825 páginas genuinas por canal, porque un detector ruidoso es uno que los analistas aprenden a apagar). Atrapó el 20%. Ajustada (fine-tuned) en páginas de documentos, la misma arquitectura atrapó el 90% después de nuestra conversión de subida, el 85% después de un viaje a través de WhatsApp, y el 95% en páginas de un modelo de imagen que nunca vio en el entrenamiento.
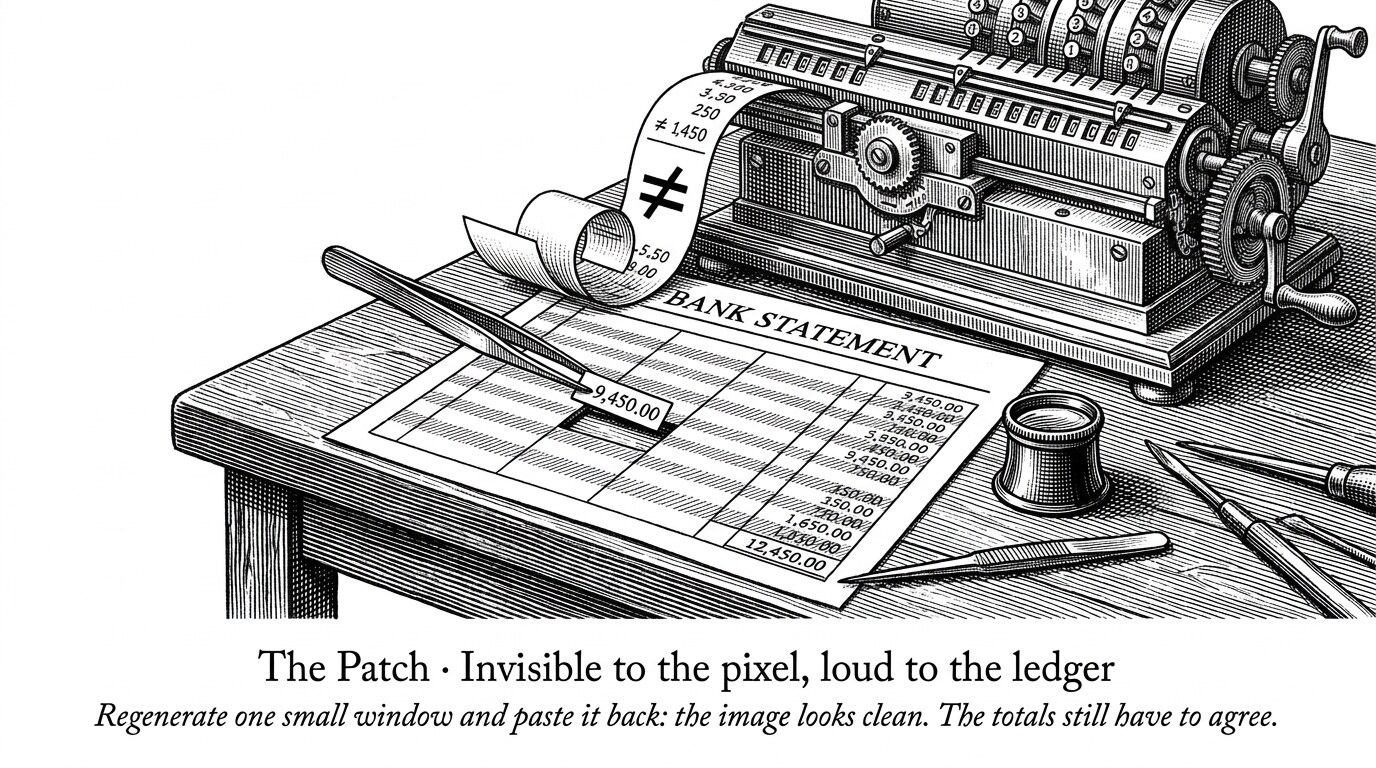
Aquí está la trampa, y por qué la detección de píxeles no puede sostenerse por sí sola: cuando un falsificador recorta un pequeño parche, regenera solo eso y lo vuelve a pegar, la detección cae a casi cero. Entre el 0% y el 4%, incluso a resolución nativa.
Dos capas, dos puntos ciegos, sin superposición
Proporción de páginas regeneradas por IA atrapadas, en un umbral que marca el 1% de las páginas genuinas.
Ahí es donde las capas dejan de ser una lista de verificación y comienzan a cubrirse mutuamente. Un modelo de imagen al que se le pide cambiar un número en una página densa tiende a redibujarla toda: los dígitos en otros lugares se desplazan, las palabras vuelven ligeramente distorsionadas. El detector de píxeles ve el re-renderizado. Y un falsificador cuidadoso que regenera solo un pequeño parche para pasar desapercibido se topa directamente con la ecuación de saldo, la suma de comprobación del IBAN y el sello criptográfico.
Dos hábitos más pequeños también importan aquí. Leemos cada subida de imagen antes de convertirla a PDF, porque la conversión borra el historial del JPEG, la miniatura incrustada de la cámara y cualquier afirmación de procedencia. Algunos generadores etiquetan su propia salida como hecha por IA en los metadatos del archivo, y nadie falsifica esa etiqueta en su contra. Las copias despojadas de metadatos no la llevarán, por lo que su ausencia no significa nada. Su presencia significa mucho.
No verificado no es aprobado
La regla individual más importante en nuestro motor de fraude es aburrida: cuando un control no puede ejecutarse, lo dice.
La mayoría de los escaneos no tienen un parser que los lea, por lo que la aritmética no puede ejecutarse. Muchos documentos no coinciden con ninguna plantilla de referencia, por lo que las comparaciones de plantillas no pueden ejecutarse. Un punto verde junto a un control significa "verificado, no se encontró nada". Mostrar ese punto para un control que nunca se ejecutó le dice al revisor que un escaneo fue verificado cuando ni siquiera fue leído.
Un punto hueco no es uno verde
Cómo un análisis reporta un escaneo de un banco que nuestros parsers aún no leen.
Aprendimos esto por las malas. En producción, exactamente el mismo archivo una vez obtuvo 98,75 (alto riesgo), y tres horas después 0,0 (confiable). En la primera ejecución, la coincidencia visual de plantilla volvió vacía. En lugar de abstenerse, seis controles recurrieron a una línea base genérica de extracto bancario y marcaron un documento ordinario como tremendamente anormal. Ahora esos controles se abstienen, el análisis dice "no verificado" con el motivo, y una comparación faltante puede costarle a un documento su insignia de confiable, pero nunca puede condenar a un solicitante.
Dos números, no uno
Un detector de fraude tiene dos formas de fallar. Puede marcar a personas honestas, y puede pasar por alto falsificaciones. La mayoría de las cifras de precisión publicadas miden una de ellas, en un conjunto que nadie más puede ver.
Nosotros mantenemos ambas, y medimos ambas frente a cada cambio.
Precisión, en lo que los clientes realmente suben. Antes de que se envíe cualquier cambio de señal, lo reproducimos contra análisis de producción almacenados. Cuando endurecimos nuestras reglas de veredicto para requerir contradicciones en lugar de anomalías acumuladas, la pila de alto riesgo en 224 documentos de clientes de una ventana de 30 días pasó de 90 a 9, y ninguna de las falsificaciones que habíamos confirmado a mano salió de ella.
Recall, en falsificaciones que hacemos nosotros mismos. Nadie te entrega un conjunto etiquetado del fraude que pasaste por alto, así que construimos el nuestro: documentos genuinos, falsificados de docenas de formas, cada falsificación pasada por el pipeline real. En 2.080 falsificaciones, agregar los controles de contenido anteriores llevó la tasa de captura del 35,4% al 63,6%. Antes de ellos, las falsificaciones cuyo único defecto era que las cifras no cuadraban eran atrapadas el 5% de las veces.
Ambas direcciones, medidas antes de cada cambio
63,6% significa que alrededor de un tercio aún pasa. Publicamos ese número porque la alternativa es publicar uno más atractivo que no podríamos defender. El benchmark también nos dice exactamente qué tercio: un nombre de titular de cuenta editado (0 de 48), extractos que ningún parser lee, una edición cuidadosa que repara cada total. Esa lista es la hoja de ruta.
Dónde nos deja esto
En Holofin, el fraude documental es uno de los problemas por los que nos pagan para ser paranoicos, y el trabajo anterior sigue algunas reglas con las que no empezamos:
- Un veredicto se basa en una contradicción. Los recuentos y las anomalías clasifican la cola. Solo un documento que no puede ser verdadero es condenado.
- Cada comparación necesita una referencia, o se abstiene. La plantilla coincidente del emisor, o lo que este productor de PDF emite normalmente. De lo contrario, "no verificado".
- Lee la afirmación, no solo el contenedor. Cifras al centavo, fechas que el banco realmente imprimió, sumas de comprobación, sellos contra la clave del emisor, el aspecto del emisor.
- Nunca confíes en la capa de texto para una cifra. Lo que una página dibuja y lo que dice pueden diferir, a propósito.
- Mide ambas direcciones. Precisión en tráfico real, recall en falsificaciones, antes de cada cambio.
En la práctica, eso son 92 señales a través de la estructura del archivo, tipografía, metadatos, píxeles, sellos criptográficos y aritmética financiera, cada una capaz de señalar la página, la región y, cuando puede, el campo que falló.
Un falsificador puede borrar cómo se hizo un documento, y hacer que lo que queda parezca real. Lo que dice aún tiene que ser verdadero: al centavo, contra la clave del emisor, con el propio aspecto del emisor. Esa parte no sale en el lavado.
Artículos relacionados
Tu extractor de tablas aprobó. Los números no.
Una auditora abre el resultado de tu extracción de un balance general. El modelo reporta una precisión de celdas del 99.2%. Impresionante. Luego, suma la columna de activos a mano, como hacen los auditores, y el resultado es un número desfasado por una fila. Los activos ya no equivalen a los pasivos más el patrimonio. El estado financiero no cuadra.
Detección de fraude documental: Lo que un PDF no puede ocultar
Solíamos pensar que el fraude documental era un problema visual. Fuentes incorrectas. Columnas desalineadas. Un logotipo que se sentía ligeramente incorrecto. Construimos controles en torno a lo que ven los humanos, porque lo que ven los humanos era todo lo que teníamos.
Cuando los documentos contraatacan
Página 1: Resumen de cuenta, dos columnas. Página 15: Misma cuenta, tres columnas, nombres de encabezado diferentes. Página 47: Un escaneo con una mancha de café. Página 89: La página de totales, que hace referencia a transacciones que extrajiste hace 70 páginas.