Le fichier arrive au format JPEG. Une capture d'écran de téléphone d'un relevé bancaire, recadrée sur la page, légèrement inclinée. Pas de chaîne producer. Pas de polices. Pas d'historique de révision. Pas de flux de contenu. Juste un rectangle plat de pixels.
Il y a quelques mois, nous avons écrit un long article sur ce qu'un PDF ne peut pas cacher : les marqueurs d'éditeur, les tables de polices, les sauvegardes incrémentales qui conservent l'historique d'édition du fichier. Tout est vrai. Tout a disparu ici. Ce fichier n'a plus rien à cacher, car celui qui l'a créé a jeté la structure du fichier.
Quand le fichier ne parle plus, le document doit encore le faire.
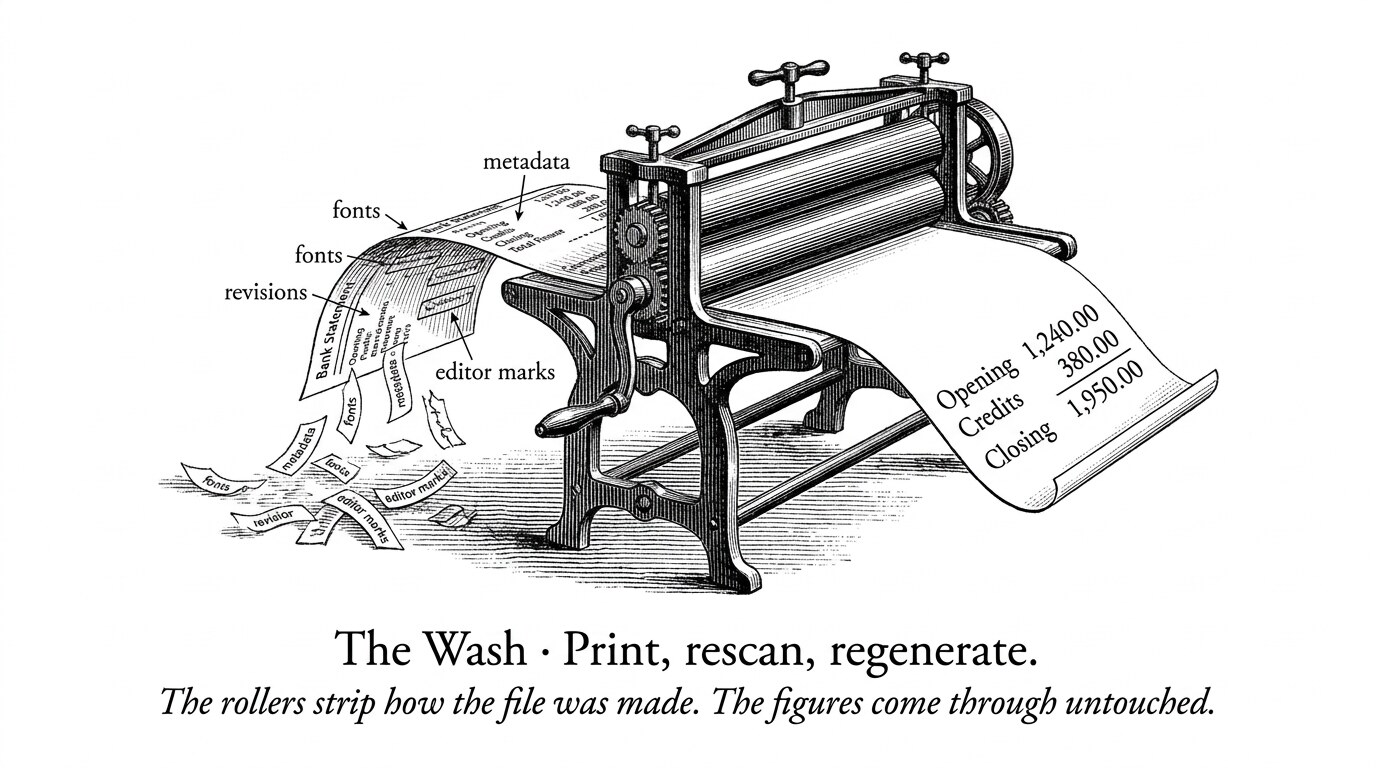
Trois façons de laver un document
L'analyse forensique structurelle a un angle mort que tout faussaire sérieux a trouvé : elle inspecte le conteneur du fichier, et le conteneur est optionnel.
Il y a trois façons courantes de s'en débarrasser.
- Imprimer et numériser à nouveau. La modification a lieu dans un éditeur PDF, le résultat passe par une imprimante et un scanner, et ce qui en ressort est la numérisation honnête d'une page malhonnête. Toute trace structurelle reste sur le premier ordinateur.
- Régénérer. Confiez la page à un modèle d'image avec « change le solde de clôture à 4 820,00 ». Il renvoie une nouvelle image. Pas un fichier modifié : un nouveau fichier, sans aucun historique.
- Changer de format. Exportez en PDF, faites-en une capture d'écran, envoyez la capture, laissez le système de réception la réemballer dans un PDF. Chaque conversion blanchit un peu plus.
Ce qui ressort du lavage
Le même relevé falsifié, livré de quatre manières. Les preuves sur la façon dont le fichier a été créé disparaissent. Ce que le document affirme ressort intact.
| Preuve | PDF modifié | Imprimé & scanné | Régénéré par IA | Capture d'écran |
|---|---|---|---|---|
| Comment le fichier a été créé | ||||
| Marqueurs d'éditeur dans la page | présent | disparu | disparu | disparu |
| Polices, révisions, historique des objets | présent | disparu | disparu | disparu |
| Producer et métadonnées | présent | du scanner | disparu | du convertisseur |
| Ce que le document affirme | ||||
| Soldes, totaux, sommes cumulées | intact | intact | intact | intact |
| Clés de contrôle IBAN et RIB | intact | intact | intact | intact |
| Cachet 2D-Doc signé par l'émetteur | intact | intact | redessiné | intact |
| L'identité visuelle de l'émetteur | intact | intact | intact | intact |
Un détecteur qui ne lit que le fichier se retrouve coincé avec deux mauvaises options lorsqu'un scan arrive. Pour le fichier, chaque scan se ressemble : un nouveau producer, aucune police, une image par page, modifié ou non. Il traite donc chaque scan comme suspect, et les analystes apprennent à l'ignorer, ou bien il laisse passer chaque scan, et les faussaires apprennent à imprimer.
Dans les deux cas, il juge le scanner, pas la modification.
Ce qui survit au lavage
Voici ce qu'un faussaire ne peut pas blanchir : les affirmations.
Un relevé bancaire affirme un solde d'ouverture, une liste de transactions, un solde de clôture et une période de relevé. Il affirme un IBAN dont les clés de contrôle sont calculées à partir du reste. Il affirme provenir d'une banque spécifique, avec l'en-tête et la mise en page de cette banque. Un avis d'imposition français peut porter un cachet que l'administration émettrice a signé avec sa clé privée.
L'impression n'efface rien de tout cela. Passer la page à travers un modèle d'image ne l'efface pas non plus : cela fait simplement de la cohérence le problème du faussaire. La question s'inverse donc. Non plus « comment ce fichier a-t-il été créé ? » mais « ce document peut-il être vrai ? »
Ce changement nous a obligés à revoir la façon dont nous pesons les preuves. Aujourd'hui, chacun de nos 92 signaux appartient à l'un des quatre niveaux, et ce niveau décide de ce qu'un signal est autorisé à faire sur un verdict.
Toutes les preuves ne sont pas autorisées à condamner
Le niveau d'un signal, et non son nombre, décide de son impact sur un verdict. Une vingtaine d'anomalies équivaut toujours à « mérite un coup d'œil ».
L'analyse forensique structurelle se situe principalement dans les deux niveaux intermédiaires. Le lavage détruit les deux. Les contradictions sont les preuves qui survivent au lavage, c'est donc là que nous avons creusé.
L'arithmétique, au centime près
Une équation de solde est la plus vieille vérification qui soit : solde d'ouverture, plus les crédits, moins les débits, égale le solde de clôture. Tout le monde dit le faire. Les détails décident si cela fonctionne ou si cela vous ment.
La tolérance. Notre pipeline d'extraction réconcilie les soldes avec une tolérance de 0,02 €, car un modèle lisant un scan bruité laissera parfois tomber un centime et nous ne voulons pas rejeter un relevé honnête pour cela. Le contrôle de fraude utilise 0,005 €. Deux modifications d'un centime déplacent un solde d'exactement 0,02 €, et un faussaire qui connaît votre tolérance sait combien il peut voler par ligne.
Plus d'une équation. Un relevé imprime la même vérité plusieurs fois. La ligne des totaux doit être égale à la somme des lignes. Le résumé de l'en-tête doit être égal aux totaux. Un solde intermédiaire imprimé au milieu du tableau (une ligne de fin de mois « SOLDE AU 30/11 ») doit correspondre au total cumulé à cette ligne exacte. Changez une transaction, et un faussaire a maintenant quatre nombres à réparer au lieu d'un.
Le faussaire a corrigé le solde de clôture. Trois autres équations sont toujours en désaccord.
Un crédit de salaire augmenté de 1 000 €, et le solde de clôture augmenté pour correspondre, de sorte que la vérification classique du solde passe. Le relevé imprime la même vérité à trois autres endroits, et personne ne les a corrigés.
| Date · libellé | Débit | Crédit | Solde |
|---|---|---|---|
| 01/10 · Solde d'ouverture | 2 104,30 | ||
| 02/10 · Salaire, ACME SAS | 2 480,00modifié | ||
| 05/10 · Loyer | 850,00 | ||
| Solde au 15/10 | 2 734,30 | ||
| 18/10 · Paiements carte | 127,45 | ||
| 24/10 · Virement reçu | 300,00 | ||
| Totaux | 977,45 | 1 780,00 | |
| 31/10 · Solde de clôture | 3 906,85modifié aussi |
Dates et identifiants. Chaque transaction doit se situer dans la période imprimée. Une période ne doit pas se terminer avant de commencer. Un IBAN comporte une clé de contrôle MOD-97, et un IBAN français comporte également une clé RIB. Changez un chiffre et les deux se cassent, à moins que le faussaire ne les recalcule.
Voici ce qui s'est passé lorsque nous avons falsifié sur place des relevés natifs numériques (même police, sauvegarde propre, aucune trace structurelle) et que nous les avons testés avec ces vérifications désactivées, puis activées :
Des modifications que le fichier ne peut pas voir, attrapées par la page
Chacune de ces modifications laisse le PDF structurellement propre. Avant les vérifications de contenu, les quatre ont été attrapées 0 fois.
Zéro avant, car ces modifications ont été sauvegardées proprement, sur place, dans la même police. Le fichier n'avait rien à dire à leur sujet. La page, si.
Les cicatrices
Deux choses que nous avons apprises à nos dépens.
Ne faites jamais confiance à une année que vous avez déduite. De nombreux relevés impriment « 31.10 » sans année, et chaque parseur la devine. Sur les relevés authentiques d'une banque, notre parseur plaçait les dates de valeur exactement un an plus tôt chaque fois qu'une transaction franchissait la limite d'un mois : 364 jours de décalage, sur chaque échantillon. Une vérification de date qui aurait fait confiance à cette supposition aurait signalé chaque client honnête de cette banque. Une date ne compte comme preuve que lorsque la banque a imprimé son année.
Une vérification de cohérence est une affirmation sur votre lecteur tout autant que sur le document. Lorsque nous avons exécuté la vérification de solde pour la première fois sur des relevés de production bruts, elle s'est déclenchée sur 19 % d'entre eux. Ce n'était pas une vague de fraude. C'était notre parseur qui lisait mal les lignes, trouvant typiquement une ligne sans son montant. Une contradiction arithmétique n'est une preuve que si vous êtes certain d'avoir bien lu les chiffres. La vérification ne s'exécute donc que là où nous lisons directement le propre texte du PDF, sur des pages natives numériques, sans OCR entre les deux. Et à elle seule, elle lève un avertissement, pas un verdict.
Vous n'avez pas besoin d'un faussaire pour échouer à une vérification de solde. Vous avez juste besoin d'un bug de parseur.
Le texte qui dit une chose et en dessine une autre
Il y a un piège dans « lire directement le propre texte du PDF ». Un faussaire qui sait que nous faisons confiance au texte natif numérique peut sauter complètement le lavage et mentir au parseur à la place. Chaque pipeline d'extraction lit la couche de texte, le nôtre et chaque pipeline LLM inclus, ce qui fait de la couche de texte elle-même une surface d'attaque.
Un PDF peut attacher un remplacement /ActualText à une suite de glyphes, dessinant un chiffre à l'écran tout en en fournissant un autre à chaque extracteur de texte. La table /ToUnicode d'une police peut être recâblée pour que la forme soit un 7 et le texte copié soit un 1. L'analyste humain voit un relevé. La vérification automatisée du solde en valide un autre. Les deux passent, car ils lisent deux documents différents.
Une page, deux documents
Les glyphes et la couche de texte sont des choses distinctes dans un PDF. Rien ne les oblige à être d'accord.
BT /F1 11 Tf 412 318 Td
/Span << /ActualText (1,450.00) >> BDC
  (9,450.00) Tj            % les glyphes qu'un humain voit
EMC
ETNous avons donc cessé de faire confiance à la couche de texte pour les nombres. Nous prenons chaque chiffre qu'une police prétend dessiner, le rendons seul, le relisons avec l'OCR, et le comparons avec la couche de texte. Dans notre benchmark, cela a attrapé 101 des 101 échanges /ActualText, avec zéro déclenchement sur 208 fichiers authentiques.
Nous avons rencontré une version plus grossière de la même idée en production, sur un relevé prétendant provenir d'une grande banque française. Le faussaire n'a pas pris la peine de supprimer les transactions d'origine : il a dessiné des rectangles blancs opaques sur les lignes et a tapé de nouveaux chiffres par-dessus, 48,00 se trouvant directement sur 162,00. À l'époque, notre moteur l'avait évalué comme normal. Aujourd'hui, nous vérifions l'ordre de dessin pour les montants enfouis sous un remplissage opaque ultérieur avec du nouveau texte dessiné par-dessus, et il obtient un score de risque élevé. (La vérification a besoin des deux moitiés. Un remplissage blanc seul s'est déclenché sur 13 fichiers authentiques, car certains pilotes d'impression ombrent les cellules de tableau après avoir dessiné le texte.)
Si votre contrôle de fraude et votre extracteur lisent la même couche de texte, un faussaire n'a à la tromper qu'une seule fois.
La cryptographie survit au scanner
Jusqu'à présent, chaque vérification demande si le document est en accord avec lui-même. Un faussaire minutieux peut gagner à ce jeu. S'il modifie une transaction puis met soigneusement à jour la ligne des totaux, le résumé de l'en-tête et le solde cumulé, l'arithmétique seule ne l'attrapera pas.
Certains documents comportent une vérification qu'aucune minutie ne peut déjouer. Les administrations et les fournisseurs d'énergie français impriment un 2D-Doc : un code-barres Data Matrix contenant les champs clés du document (nom, adresse, montants d'impôts, période de référence), signé avec la clé privée de l'émetteur selon la norme de l'ANTS.
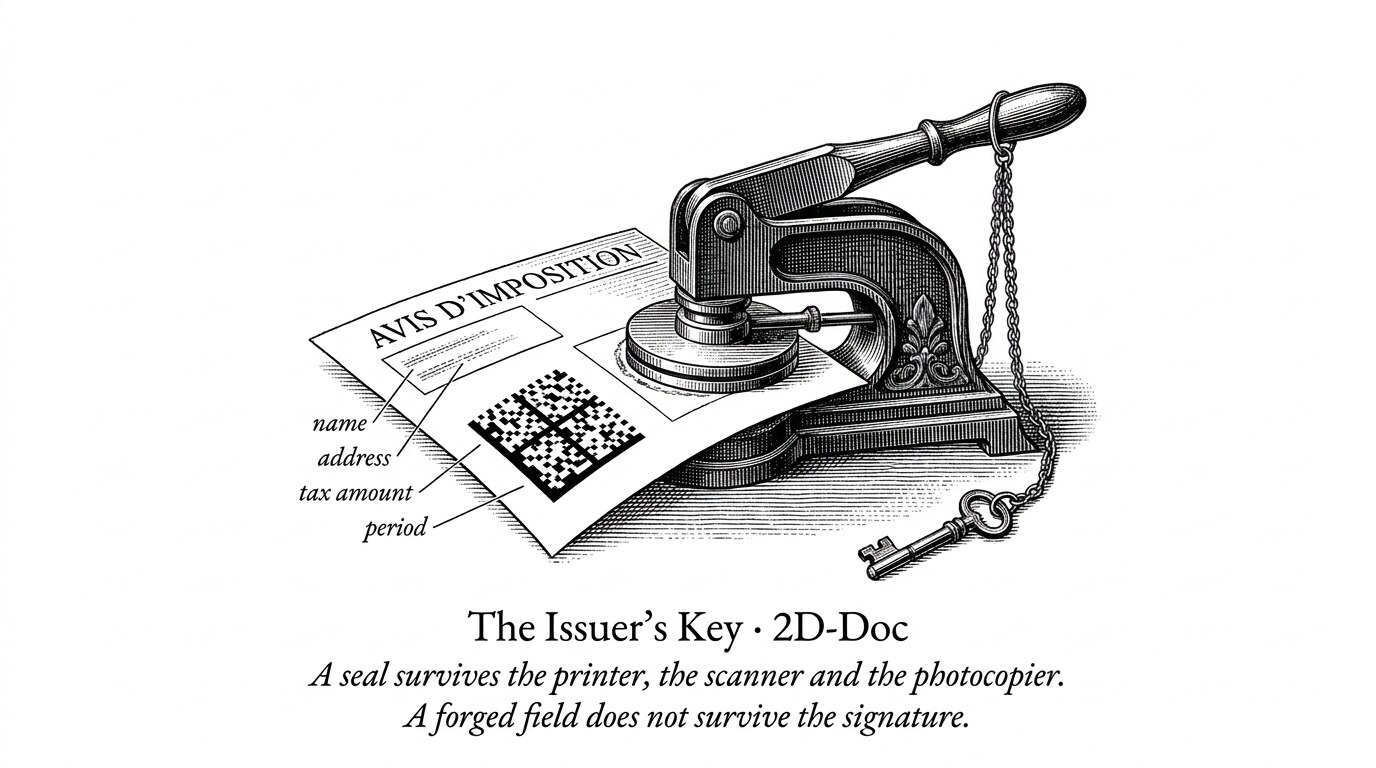
Le cachet possède une propriété que les preuves structurelles n'ont jamais eue : il survit au lavage. Un code-barres s'imprime et se numérise à nouveau parfaitement bien.
Vérifier un document par rapport à son émetteur, pas par rapport à lui-même
Le cachet est lu à partir des pixels, il fonctionne donc sur un scan, une photo ou une impression d'une impression.
Ce dernier cas provenait d'un groupe d'avis d'imposition construits avec un kit de publication assistée par ordinateur. Le code-barres avait l'air correct. Quelqu'un a dessiné l'image d'un cachet, en espérant que personne ne le scannerait.
La vérification de cohérence la plus forte n'est pas que le document soit en accord avec lui-même. C'est que le document soit en accord avec la clé de son émetteur.
Ressemble-t-il à ce qu'il prétend être ?
La falsification la moins chère ne touche pas aux chiffres. Elle prend un relevé authentique d'une petite banque et y colle l'en-tête d'une grande banque par-dessus.
Les chiffres sont honnêtes. Seul l'en-tête ment. Nous comparons donc la page, zone par zone, avec des pages de référence vérifiées pour chaque famille de banques et demandons à laquelle elle ressemble réellement. Lorsque la banque qu'elle nomme et la banque à laquelle elle ressemble sont en désaccord avec une marge claire, nous signalons l'incohérence.
Sur un ensemble de test mis de côté, cela a attrapé 75 % des faux avec échange d'en-tête tout en ne se déclenchant que sur 1 des 213 documents authentiques. Ce seul faux positif est instructif : un fichier dont la première page était le verso de la banque, qui ne ressemble à l'en-tête de personne.
Et oui, les pixels
Rien de tout cela ne signifie que nous ignorons l'image. Lorsqu'un document est régénéré par un modèle d'image, les pixels sont le seul endroit où le modèle laisse une signature.
Les détecteurs génériques d'images IA sont entraînés sur des photos, et les documents ne sont pas des photos. Nous en avons testé un sur des pages de documents régénérées par IA, à un seuil qui ne signale que 1 % des documents authentiques (mesuré sur environ 825 pages authentiques par canal, car un détecteur bruyant est un détecteur que les analystes apprennent à désactiver). Il en a attrapé 20 %. Affinée sur des pages de documents, la même architecture en a attrapé 90 % après notre conversion de téléchargement, 85 % après un passage par WhatsApp, et 95 % sur des pages provenant d'un modèle d'image qu'elle n'avait jamais vu lors de l'entraînement.
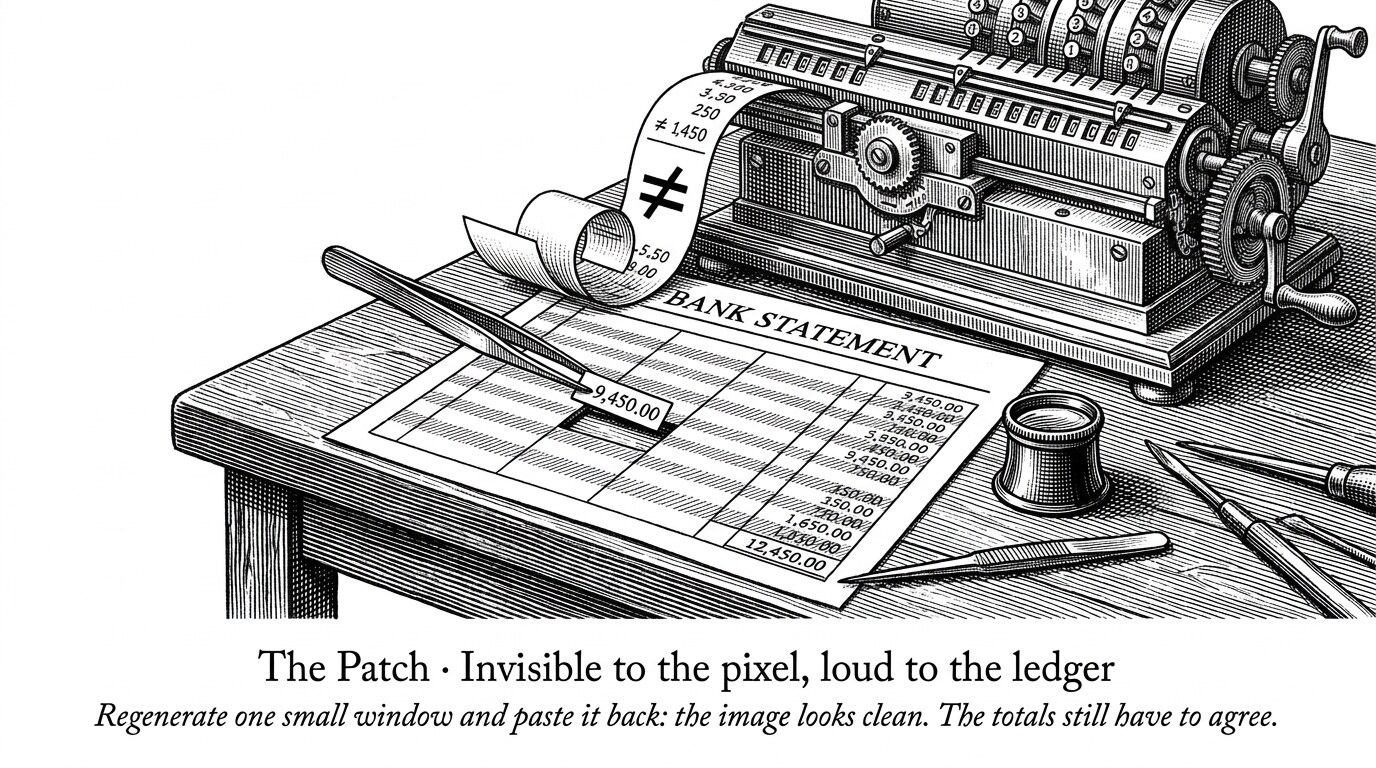
Voici le piège, et pourquoi la détection de pixels ne peut pas se suffire à elle-même : lorsqu'un faussaire découpe une petite zone, ne régénère que celle-ci et la recolle, la détection chute à presque zéro. Entre 0 % et 4 %, même à la résolution native.
Deux couches, deux angles morts, aucun chevauchement
Part des pages régénérées par IA attrapées, à un seuil qui signale 1 % des pages authentiques.
C'est là que les couches cessent d'être une simple liste de contrôle et commencent à se couvrir mutuellement. Un modèle d'image à qui l'on demande de changer un nombre sur une page dense a tendance à tout redessiner : les chiffres ailleurs se décalent, les mots reviennent légèrement déformés. Le détecteur de pixels voit le nouveau rendu. Et un faussaire minutieux qui ne régénère qu'une petite zone pour passer inaperçu fonce droit dans l'équation de solde, la clé de contrôle IBAN et le cachet cryptographique.
Deux habitudes plus modestes comptent également ici. Nous lisons chaque image téléchargée avant de la convertir en PDF, car la conversion efface l'historique JPEG, la miniature intégrée de l'appareil photo et toute revendication de provenance. Certains générateurs étiquettent leur propre sortie comme étant créée par l'IA dans les métadonnées du fichier, et personne ne falsifie cette étiquette contre soi-même. Les copies nettoyées ne la porteront pas, donc son absence ne signifie rien. Sa présence signifie beaucoup.
Non vérifié n'est pas validé
La règle la plus importante de notre moteur de fraude est ennuyeuse : lorsqu'une vérification ne peut pas s'exécuter, elle le dit.
La plupart des scans n'ont pas de parseur qui les lit, l'arithmétique ne peut donc pas s'exécuter. De nombreux documents ne correspondent à aucun modèle de référence, les comparaisons de modèles ne peuvent donc pas s'exécuter. Un point vert à côté d'une vérification signifie « vérifié, rien trouvé ». Afficher ce point pour une vérification qui ne s'est jamais exécutée indique à l'analyste qu'un scan a été vérifié alors qu'il n'a même pas été lu.
Un point creux n'est pas un point vert
Comment une analyse rapporte un scan d'une banque que nos parseurs ne lisent pas encore.
Nous l'avons appris à nos dépens. En production, le même fichier a un jour obtenu un score de 98,75 (risque élevé), et trois heures plus tard 0,0 (de confiance). Lors de la première exécution, la correspondance du modèle visuel est revenue vide. Au lieu de s'abstenir, six vérifications se sont rabattues sur une base de référence générique de relevé bancaire et ont signalé un document ordinaire comme étant extrêmement anormal. Désormais, ces vérifications s'abstiennent, l'analyse indique « non vérifié » avec la raison, et une comparaison manquante peut coûter à un document son badge de confiance mais ne peut jamais condamner un candidat.
Deux chiffres, pas un seul
Un détecteur de fraude a deux façons d'échouer. Il peut signaler des personnes honnêtes, et il peut rater des falsifications. La plupart des chiffres de précision publiés mesurent l'une d'entre elles, sur un ensemble que personne d'autre ne peut voir.
Nous gardons les deux, et mesurons les deux à chaque changement.
La précision, sur ce que les clients téléchargent réellement. Avant de déployer toute modification de signal, nous la rejouons sur des analyses de production stockées. Lorsque nous avons durci nos règles de verdict pour exiger des contradictions au lieu d'anomalies accumulées, la pile à haut risque sur 224 documents clients d'une fenêtre de 30 jours est passée de 90 à 9, et aucune des falsifications que nous avions confirmées à la main ne l'a quittée.
Le rappel, sur les falsifications que nous créons nous-mêmes. Personne ne vous remet un ensemble étiqueté des fraudes que vous avez manquées, alors nous construisons le nôtre : des documents authentiques, falsifiés de dizaines de façons, chaque faux passant par le vrai pipeline. Sur 2 080 falsifications, l'ajout des vérifications de contenu ci-dessus a fait passer le taux de capture de 35,4 % à 63,6 %. Avant elles, les falsifications dont le seul défaut était que les chiffres ne correspondaient pas étaient attrapées 5 % du temps.
Les deux directions, mesurées avant chaque changement
63,6 % signifie qu'environ un tiers passe encore. Nous publions ce chiffre car l'alternative est d'en publier un plus beau que nous ne pourrions pas défendre. Le benchmark nous dit aussi exactement quel tiers : un nom de titulaire de compte modifié (0 sur 48), des relevés qu'aucun parseur ne lit, une modification minutieuse qui répare chaque total. Cette liste est notre feuille de route.
Où cela nous mène
Chez Holofin, la fraude documentaire est l'un des problèmes pour lesquels nous sommes payés pour être paranoïaques, et le travail ci-dessus suit quelques règles avec lesquelles nous n'avons pas commencé :
- Un verdict repose sur une contradiction. Les nombres et les anomalies classent la file d'attente. Seul un document qui ne peut pas être vrai est condamné.
- Chaque comparaison nécessite une référence, ou elle s'abstient. Le modèle correspondant de l'émetteur, ou ce que ce producer PDF émet normalement. Sinon, « non vérifié ».
- Lisez l'affirmation, pas seulement le conteneur. Les chiffres au centime près, les dates que la banque a réellement imprimées, les clés de contrôle, les cachets par rapport à la clé de l'émetteur, l'apparence de l'émetteur.
- Ne faites jamais confiance à la couche de texte pour un chiffre. Ce qu'une page dessine et ce qu'elle dit peuvent différer, intentionnellement.
- Mesurez dans les deux sens. La précision sur le trafic réel, le rappel sur les falsifications, avant chaque changement.
En pratique, cela représente 92 signaux couvrant la structure du fichier, la typographie, les métadonnées, les pixels, les cachets cryptographiques et l'arithmétique financière, chacun capable de pointer vers la page, la région et, quand il le peut, le champ qui a échoué.
Un faussaire peut effacer la façon dont un document a été créé, et faire en sorte que ce qu'il en reste ait l'air vrai. Ce qu'il dit doit quand même être vrai : au centime près, par rapport à la clé de l'émetteur, dans la propre apparence de l'émetteur. Cette partie-là ne part au lavage.
Articles connexes
Forest et la nécessité de traiter la décision comme une infrastructure, pas comme une boîte de réception
Forest a fait valoir que l'OCR mérite d'être traité comme une infrastructure plutôt que comme une commodité. Voici l'argument complémentaire vu de l'amont : la couche qui reçoit les données mérite le même sérieux, car un chiffre parfaitement extrait peut toujours attendre trois jours, être approuvé par la mauvaise personne et ne laisser aucune trace de ce qui s'est passé.
Votre extracteur de tableaux a réussi le test. Pas les chiffres.
Une auditrice ouvre votre résultat d'extraction pour un bilan. Le modèle affiche une précision par cellule de 99,2 %. Impressionnant. Puis elle fait le total de la colonne des actifs à la main, comme le font les auditeurs, et obtient un chiffre décalé d'une ligne. Les actifs ne sont plus égaux au passif plus les capitaux propres. Le bilan ne s'équilibre pas.
Détection de fraude documentaire : ce qu'un PDF ne peut pas cacher
Nous pensions que la fraude documentaire était un problème visuel. Mauvaises polices. Colonnes mal alignées. Un logo qui semblait légèrement décalé. Nous avons construit des vérifications basées sur ce que les humains voient, car ce que les humains voient était tout ce que nous avions.