Die Datei kommt als JPEG an. Ein Handy-Screenshot eines Kontoauszugs, auf die Seite zugeschnitten, leicht geneigt. Kein Producer-String. Keine Schriftarten. Keine Revisionshistorie. Kein Content-Stream. Nur ein flaches Rechteck aus Pixeln.
Vor ein paar Monaten haben wir einen ausführlichen Artikel darüber geschrieben, was ein PDF nicht verbergen kann: die Editor-Marker, die Font-Tabellen, die inkrementellen Speicherungen, die die eigene Bearbeitungshistorie einer Datei festhalten. Alles wahr. Hier ist alles weg. Diese Datei hat nichts mehr zu verbergen, denn wer auch immer sie erstellt hat, hat die Dateistruktur weggeworfen.
Wenn die Datei aufhört zu sprechen, muss das Dokument es immer noch tun.
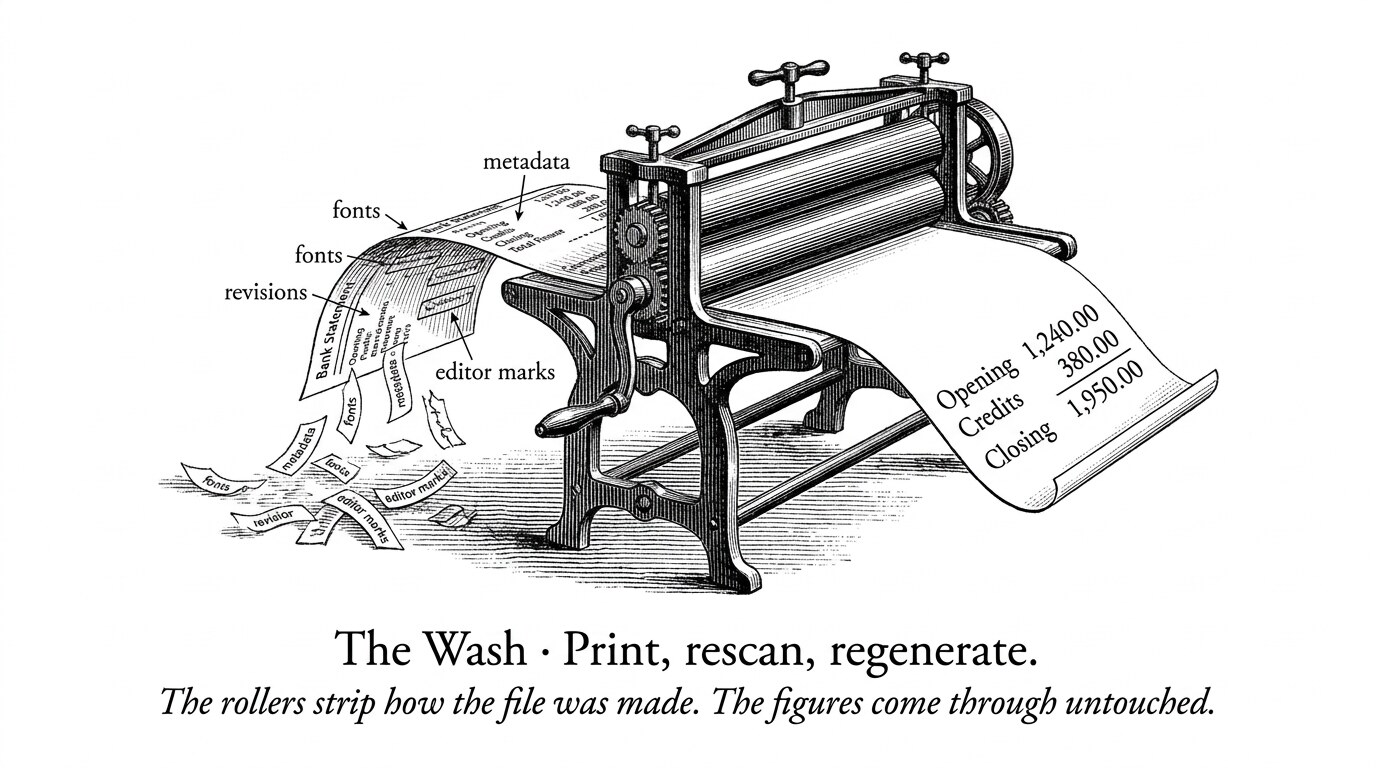
Drei Wege, ein Dokument zu waschen
Die strukturelle Forensik hat einen blinden Fleck, den jeder ernsthafte Fälscher gefunden hat: Sie untersucht den Container der Datei, und der Container ist optional.
Es gibt drei gängige Wege, ihn wegzuwerfen.
- Drucken und neu einscannen. Die Bearbeitung findet in einem PDF-Editor statt, das Ergebnis geht durch einen Drucker und einen Scanner, und was herauskommt, ist ein ehrlicher Scan einer unehrlichen Seite. Jede strukturelle Spur bleibt auf dem ersten Computer.
- Neu generieren. Man übergibt die Seite an ein Bildmodell mit der Anweisung "ändere den Schlusssaldo auf 4.820,00". Es liefert ein neues Bild zurück. Keine bearbeitete Datei: eine neue, ganz ohne Historie.
- Formate wechseln. Als PDF exportieren, einen Screenshot davon machen, den Screenshot senden, das empfangende System ihn wieder in ein PDF verpacken lassen. Jede Konvertierung wäscht ein bisschen mehr.
Was bei der Wäsche herauskommt
Derselbe gefälschte Kontoauszug, auf vier Wegen geliefert. Die Beweise dafür, wie die Datei erstellt wurde, verschwinden. Was das Dokument behauptet, kommt unberührt durch.
| Beweis | Bearbeitetes PDF | Drucken & scannen | KI-generiert | Screenshot-Wechsel |
|---|---|---|---|---|
| Wie die Datei erstellt wurde | ||||
| Editor-Marker auf der Seite | vorhanden | weg | weg | weg |
| Schriftarten, Revisionen, Objekt-Historie | vorhanden | weg | weg | weg |
| Producer und Metadaten | vorhanden | vom Scanner | weg | vom Konverter |
| Was das Dokument behauptet | ||||
| Salden, Summen, laufende Summen | intakt | intakt | intakt | intakt |
| IBAN- und RIB-Prüfziffern | intakt | intakt | intakt | intakt |
| Vom Aussteller signiertes 2D-Doc-Siegel | intakt | intakt | neu gezeichnet | intakt |
| Die visuelle Identität des Ausstellers | intakt | intakt | intakt | intakt |
Ein Detektor, der nur die Datei liest, steht bei Eintreffen eines Scans vor zwei schlechten Optionen. Für die Datei sieht jeder Scan gleich aus: ein neuer Producer, keine Schriftarten, ein Bild pro Seite, bearbeitet oder nicht. Also behandelt er entweder jeden Scan als verdächtig, und Analysten lernen, ihn zu ignorieren, oder er winkt jeden Scan durch, und Fälscher lernen zu drucken.
So oder so beurteilt er den Scanner, nicht die Bearbeitung.
Was die Wäsche übersteht
Hier ist die Sache, die ein Fälscher nicht waschen kann: die Behauptungen.
Ein Kontoauszug behauptet einen Anfangssaldo, eine Liste von Transaktionen, einen Schlusssaldo und einen Abrechnungszeitraum. Er behauptet eine IBAN, deren Prüfziffern aus dem Rest berechnet werden. Er behauptet, von einer bestimmten Bank zu stammen, mit dem Briefkopf und Layout dieser Bank. Ein französischer Steuerbescheid kann ein Siegel tragen, das die ausstellende Behörde mit ihrem privaten Schlüssel signiert hat.
Drucken löscht nichts davon. Die Seite durch ein Bildmodell zu jagen, löscht es auch nicht: Es macht Konsistenz lediglich zum Problem des Fälschers. Die Frage dreht sich also um. Nicht "wie wurde diese Datei erstellt?", sondern "kann dieses Dokument wahr sein?"
Dieser Wechsel zwang uns, die Gewichtung von Beweisen zu ändern. Heute gehört jedes unserer 92 Signale zu einer von vier Stufen, und die Stufe entscheidet, was ein Signal mit einem Urteil machen darf.
Nicht jeder Beweis darf verurteilen
Die Stufe eines Signals, nicht seine Anzahl, entscheidet, was es mit einem Urteil machen kann. Zwanzig seltsame Auffälligkeiten ergeben immer noch nur ein "einen Blick wert".
Die strukturelle Forensik bewegt sich meist in den mittleren beiden Stufen. Waschen zerstört beide. Widersprüche sind die Beweise, die die Wäsche überstehen, also haben wir dort angesetzt.
Arithmetik, auf den Cent genau
Eine Saldengleichung ist die älteste Prüfung überhaupt: Anfangssaldo, plus Haben, minus Soll, gleich Schlusssaldo. Jeder sagt, er tut es. Die Details entscheiden, ob es funktioniert oder Sie anlügt.
Die Toleranz. Unsere Extraktions-Pipeline gleicht Salden mit einer Toleranz von 0,02 € ab, da ein Modell, das einen verrauschten Scan liest, gelegentlich einen Cent verschluckt und wir einen ehrlichen Auszug deswegen nicht durchfallen lassen wollen. Die Betrugsprüfung verwendet 0,005 €. Zwei Ein-Cent-Änderungen verschieben einen Saldo um genau 0,02 €, und ein Fälscher, der Ihre Toleranz kennt, weiß, wie viel er pro Zeile stehlen kann.
Mehr als eine Gleichung. Ein Auszug druckt dieselbe Wahrheit mehrmals. Die Summenzeile muss der Summe der Zeilen entsprechen. Die Zusammenfassung im Kopfbereich muss den Summen entsprechen. Ein Zwischensaldo, der mitten in der Tabelle gedruckt wird (eine Zeile am Monatsende "SOLDE AU 30/11"), muss mit der laufenden Summe genau in dieser Zeile übereinstimmen. Ändert man eine Transaktion, muss ein Fälscher nun vier Zahlen reparieren statt einer.
Der Fälscher hat den Schlusssaldo korrigiert. Drei andere Gleichungen stimmen immer noch nicht überein.
Eine Gehaltsgutschrift um 1.000 € erhöht und der Schlusssaldo passend dazu angehoben, sodass die klassische Saldenprüfung bestanden wird. Der Auszug druckt dieselbe Wahrheit an drei weiteren Stellen, und niemand hat diese korrigiert.
| Datum · Buchungstext | Soll | Haben | Saldo |
|---|---|---|---|
| 01.10. · Anfangssaldo | 2.104,30 | ||
| 02.10. · Gehalt, ACME SAS | 2.480,00bearbeitet | ||
| 05.10. · Miete | 850,00 | ||
| Saldo am 15.10. | 2.734,30 | ||
| 18.10. · Kartenzahlungen | 127,45 | ||
| 24.10. · Überweisungseingang | 300,00 | ||
| Summen | 977,45 | 1.780,00 | |
| 31.10. · Schlusssaldo | 3.906,85auch bearbeitet |
Daten und Identifikatoren. Jede Transaktion sollte innerhalb des gedruckten Zeitraums liegen. Ein Zeitraum sollte nicht enden, bevor er beginnt. Eine IBAN enthält eine MOD-97-Prüfsumme, und eine französische enthält zusätzlich einen RIB-Schlüssel. Ändert man eine Ziffer, brechen beide, es sei denn, der Fälscher berechnet sie neu.
Hier ist, was passierte, als wir digital erstellte (born-digital) Auszüge direkt im Dokument fälschten (gleiche Schriftart, sauberes Speichern, keinerlei strukturelle Spuren) und sie mit diesen Prüfungen zuerst aus- und dann eingeschaltet durchlaufen ließen:
Bearbeitungen, die die Datei nicht sehen kann, von der Seite erfasst
Jede dieser Bearbeitungen hinterlässt das PDF strukturell sauber. Vor den inhaltlichen Prüfungen wurden alle vier 0 Mal erfasst.
Vorher null, weil diese Bearbeitungen sauber, an Ort und Stelle und in derselben Schriftart gespeichert wurden. Die Datei hatte dazu nichts zu sagen. Die Seite schon.
Die Narben
Zwei Dinge, die wir auf die harte Tour gelernt haben.
Vertrauen Sie niemals einem abgeleiteten Jahr. Viele Auszüge drucken "31.10." ohne Jahr, und jeder Parser rät es. Bei den echten Auszügen einer Bank setzte unser Parser die Wertstellungsdaten genau ein Jahr zu früh an, wann immer eine Transaktion eine Monatsgrenze überschritt: 364 Tage daneben, bei jedem Beispiel. Eine Datumsprüfung, die dieser Schätzung vertraut hätte, hätte jeden ehrlichen Kunden dieser Bank markiert. Ein Datum zählt nur dann als Beweis, wenn die Bank das Jahr gedruckt hat.
Eine Kohärenzprüfung ist eine Aussage über Ihren Reader genauso wie über das Dokument. Als wir die Saldenprüfung zum ersten Mal über rohe Produktionsauszüge laufen ließen, schlug sie bei 19 % davon an. Das war keine Betrugswelle. Es war unser Parser, der Zeilen falsch las und typischerweise eine Zeile ohne ihren Betrag fand. Ein arithmetischer Widerspruch ist nur dann ein Beweis, wenn Sie sicher sind, dass Sie die Zahlen richtig gelesen haben. Daher läuft die Prüfung nur dort, wo wir den eigenen Text des PDFs direkt lesen, auf digital erstellten Seiten, ohne OCR dazwischen. Und für sich allein genommen löst sie eine Warnung aus, kein Urteil.
Sie brauchen keinen Fälscher, um bei einer Saldenprüfung durchzufallen. Sie brauchen nur einen Parser-Bug.
Der Text, der das eine sagt und das andere zeichnet
Es gibt einen Haken bei "den eigenen Text des PDFs direkt lesen". Ein Fälscher, der weiß, dass wir digital erstelltem Text vertrauen, kann die Wäsche komplett überspringen und stattdessen den Parser anlügen. Jede Extraktions-Pipeline liest die Textebene, unsere und jede LLM-Pipeline eingeschlossen, was die Textebene selbst zu einer Angriffsfläche macht.
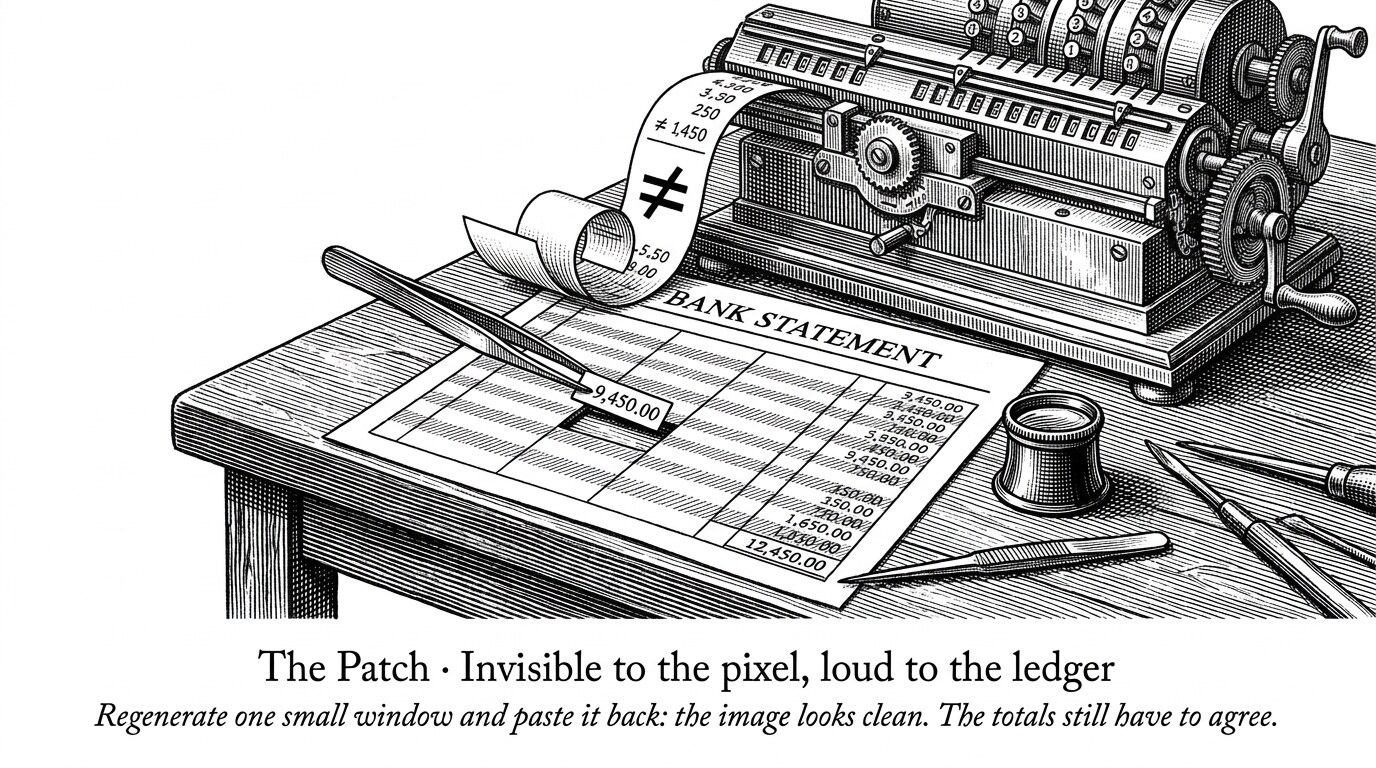
Ein PDF kann einem Lauf von Glyphen eine /ActualText-Ersetzung anhängen, wodurch eine Zahl auf dem Bildschirm gezeichnet wird, während jedem Text-Extraktor eine andere zugeführt wird. Die /ToUnicode-Map einer Schriftart kann so umverdrahtet werden, dass die Form eine 7 ist und der kopierte Text eine 1. Der menschliche Prüfer sieht den einen Auszug. Die automatisierte Saldenprüfung validiert einen anderen. Beide bestehen, weil sie zwei verschiedene Dokumente lesen.
Eine Seite, zwei Dokumente
Die Glyphen und die Textebene sind in einem PDF getrennte Dinge. Nichts zwingt sie dazu, übereinzustimmen.
BT /F1 11 Tf 412 318 Td
/Span << /ActualText (1,450.00) >> BDC
  (9,450.00) Tj            % die Glyphen, die ein Mensch sieht
EMC
ETAlso haben wir aufgehört, der Textebene bei Zahlen zu vertrauen. Wir nehmen jede Ziffer, die eine Schriftart zu zeichnen vorgibt, rendern sie einzeln, lesen sie mit OCR zurück und vergleichen das mit der Textebene. In unserem Benchmark hat dies 101 von 101 /ActualText-Austauschen erfasst, mit null Anschlägen bei 208 echten Dateien.
Wir sind in der Produktion auf eine gröbere Version derselben Idee gestoßen, bei einem Auszug, der vorgab, von einer großen französischen Bank zu stammen. Der Fälscher machte sich nicht die Mühe, die ursprünglichen Transaktionen zu löschen: Er zeichnete undurchsichtige weiße Rechtecke über die Zeilen und tippte neue Zahlen darüber, sodass 48,00 direkt über 162,00 saß. Damals stufte unsere Engine dies als normal ein. Heute prüfen wir die Zeichenreihenfolge auf Beträge, die unter einer späteren undurchsichtigen Füllung mit neu darüber gezeichnetem Text begraben sind, und es wird als hohes Risiko eingestuft. (Die Prüfung benötigt beide Hälften. Eine weiße Füllung allein schlug bei 13 echten Dateien an, weil einige Druckertreiber Tabellenzellen schattieren, nachdem sie den Text gezeichnet haben.)
Wenn Ihre Betrugsprüfung und Ihr Extraktor dieselbe Textebene lesen, muss ein Fälscher sie nur einmal täuschen.
Kryptografie überlebt den Scanner
Jede bisherige Prüfung fragt, ob das Dokument mit sich selbst übereinstimmt. Ein sorgfältiger Fälscher kann dieses Spiel gewinnen. Wenn er eine Transaktion ändert und dann sorgfältig die Summenzeile, die Zusammenfassung im Kopfbereich und den laufenden Saldo aktualisiert, wird die Arithmetik allein ihn nicht erwischen.
Einige Dokumente enthalten eine Prüfung, die durch noch so viel Sorgfalt nicht zu überlisten ist. Französische Behörden und Versorgungsunternehmen drucken ein 2D-Doc: einen Data-Matrix-Barcode, der die Schlüsselfelder des Dokuments (Name, Adresse, Steuerbeträge, Referenzzeitraum) enthält und mit dem privaten Schlüssel des Ausstellers nach dem ANTS-Standard signiert ist.
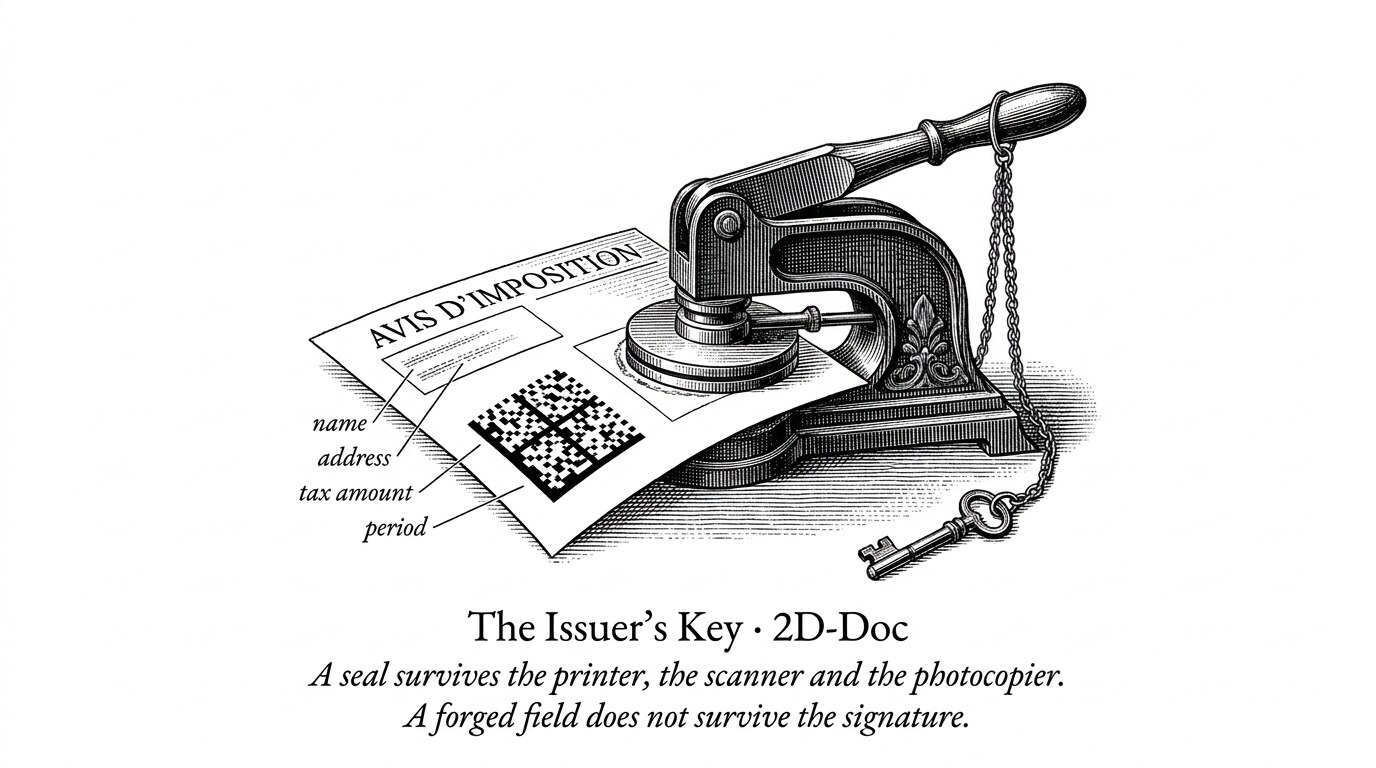
Das Siegel hat eine Eigenschaft, die strukturelle Beweise nie hatten: Es übersteht die Wäsche. Ein Barcode lässt sich einwandfrei drucken und neu einscannen.
Ein Dokument gegen seinen Aussteller prüfen, nicht gegen sich selbst
Das Siegel wird aus den Pixeln gelesen, funktioniert also bei einem Scan, einem Foto oder einem Druck eines Drucks.
Dieser letzte Fall stammte aus einer Gruppe von Steuerbescheiden, die mit einem Desktop-Publishing-Kit erstellt wurden. Der Barcode sah richtig aus. Jemand hatte das Bild eines Siegels gezeichnet, in der Hoffnung, dass niemand es scannen würde.
Die stärkste Kohärenzprüfung ist nicht, dass das Dokument mit sich selbst übereinstimmt. Es ist, dass das Dokument mit dem Schlüssel seines Ausstellers übereinstimmt.
Sieht es so aus, wie es vorgibt zu sein?
Die billigste Fälschung rührt die Zahlen nicht an. Sie nimmt einen echten Auszug einer kleinen Bank und fügt den Briefkopf einer großen Bank darüber ein.
Die Zahlen sind ehrlich. Nur der Briefkopf lügt. Also vergleichen wir die Seite, Abschnitt für Abschnitt, mit verifizierten Referenzseiten für jede Bankenfamilie und fragen, welcher sie tatsächlich ähnelt. Wenn die Bank, die sie nennt, und die Bank, nach der sie aussieht, deutlich voneinander abweichen, markieren wir die Diskrepanz.
In einem zurückgehaltenen Testdatensatz (Held-out Test Set) erfasste dies 75 % der Briefkopf-Austausch-Fälschungen, während es bei nur 1 von 213 echten Dokumenten anschlug. Dieses eine False Positive ist aufschlussreich: eine Datei, deren erste Seite die Rückseite der Bank war, die wie niemandes Briefkopf aussieht.
Und ja, die Pixel
Nichts davon bedeutet, dass wir das Bild ignorieren. Wenn ein Dokument von einem Bildmodell neu generiert wird, sind die Pixel der einzige Ort, an dem das Modell eine Signatur hinterlässt.
Generische KI-Bild-Detektoren sind auf Fotos trainiert, und Dokumente sind keine Fotos. Wir haben einen an KI-generierten Dokumentenseiten getestet, mit einem Schwellenwert, der nur 1 % der echten Dokumente markiert (gemessen an etwa 825 echten Seiten pro Kanal, denn ein verrauschter Detektor ist einer, den Analysten abzuschalten lernen). Er erfasste 20 %. Feinabgestimmt auf Dokumentenseiten erfasste dieselbe Architektur 90 % nach unserer Upload-Konvertierung, 85 % nach einer Reise durch WhatsApp und 95 % auf Seiten von einem Bildmodell, das sie im Training nie gesehen hatte.
Hier ist der Haken und der Grund, warum die Pixel-Erkennung nicht für sich allein stehen kann: Wenn ein Fälscher einen kleinen Ausschnitt ausschneidet, nur diesen neu generiert und ihn wieder einfügt, sinkt die Erkennung auf fast null. Zwischen 0 % und 4 %, selbst bei nativer Auflösung.
Zwei Ebenen, zwei blinde Flecken, keine Überschneidung
Anteil der erfassten KI-generierten Seiten bei einem Schwellenwert, der 1 % der echten Seiten markiert.
An diesem Punkt hören die Ebenen auf, eine Checkliste zu sein, und fangen an, sich gegenseitig abzusichern. Ein Bildmodell, das gebeten wird, eine Zahl auf einer dichten Seite zu ändern, neigt dazu, alles neu zu zeichnen: Ziffern an anderer Stelle verschieben sich, Wörter kommen leicht verstümmelt zurück. Der Pixel-Detektor sieht das Neu-Rendern. Und ein sorgfältiger Fälscher, der nur einen kleinen Ausschnitt neu generiert, um daran vorbeizuschlüpfen, läuft direkt in die Saldengleichung, die IBAN-Prüfsumme und das kryptografische Siegel.
Zwei kleinere Gewohnheiten spielen hier ebenfalls eine Rolle. Wir lesen jeden Bild-Upload, bevor wir ihn in ein PDF konvertieren, denn die Konvertierung löscht die JPEG-Historie, das eingebettete Thumbnail der Kamera und jeden Herkunftsnachweis. Einige Generatoren kennzeichnen ihre eigene Ausgabe in den Metadaten der Datei als KI-erstellt, und niemand fälscht dieses Label gegen sich selbst. Bereinigte Kopien tragen es nicht, also bedeutet sein Fehlen nichts. Sein Vorhandensein bedeutet eine Menge.
Nicht geprüft ist nicht bestanden
Die wichtigste Einzelregel in unserer Betrugs-Engine ist langweilig: Wenn eine Prüfung nicht laufen kann, sagt sie das auch.
Die meisten Scans haben keinen Parser, der sie liest, also kann die Arithmetik nicht laufen. Viele Dokumente passen zu keiner Referenzvorlage, also können die Vorlagenvergleiche nicht laufen. Ein grüner Punkt neben einer Prüfung bedeutet "geprüft, nichts gefunden". Diesen Punkt für eine Prüfung anzuzeigen, die nie gelaufen ist, sagt dem Prüfer, dass ein Scan verifiziert wurde, obwohl er nicht einmal gelesen wurde.
Ein hohler Punkt ist kein grüner
Wie eine Analyse einen Scan von einer Bank meldet, die unsere Parser noch nicht lesen.
Wir haben das auf die harte Tour gelernt. In der Produktion erzielte exakt dieselbe Datei einmal 98,75 (hohes Risiko) und drei Stunden später 0,0 (vertrauenswürdig). Beim ersten Durchlauf lieferte der visuelle Vorlagenabgleich ein leeres Ergebnis. Anstatt sich zu enthalten, fielen sechs Prüfungen auf eine generische Kontoauszugs-Baseline zurück und markierten ein gewöhnliches Dokument als extrem abnormal. Jetzt enthalten sich diese Prüfungen, die Analyse sagt "nicht geprüft" mit Angabe des Grundes, und ein fehlender Vergleich kann ein Dokument zwar sein Vertrauenswürdigkeits-Abzeichen kosten, aber niemals einen Antragsteller verurteilen.
Zwei Zahlen, nicht eine
Ein Betrugsdetektor kann auf zwei Arten versagen. Er kann ehrliche Menschen markieren, und er kann Fälschungen übersehen. Die meisten veröffentlichten Genauigkeitszahlen messen eine davon, an einem Datensatz, den sonst niemand sehen kann.
Wir behalten beide bei und messen beide bei jeder Änderung.
Präzision (Precision), bei dem, was Kunden tatsächlich hochladen. Bevor eine Signaländerung live geht, spielen wir sie gegen gespeicherte Produktionsanalysen ab. Als wir unsere Urteilsregeln verschärften, um Widersprüche anstelle von angehäuften Anomalien zu verlangen, schrumpfte der Hochrisiko-Stapel bei 224 Kundendokumenten aus einem 30-Tage-Fenster von 90 auf 9, und keine der Fälschungen, die wir manuell bestätigt hatten, verließ ihn.
Trefferquote (Recall), bei Fälschungen, die wir selbst erstellen. Niemand überreicht Ihnen einen gelabelten Datensatz des Betrugs, den Sie übersehen haben, also bauen wir unseren eigenen: echte Dokumente, auf Dutzende Arten gefälscht, wobei jeder Fake die echte Pipeline durchläuft. Bei 2.080 Fälschungen stieg die Erfassungsrate durch das Hinzufügen der obigen inhaltlichen Prüfungen von 35,4 % auf 63,6 %. Davor wurden Fälschungen, deren einziger Fehler darin bestand, dass die Zahlen nicht übereinstimmten, in 5 % der Fälle erfasst.
Beide Richtungen, gemessen vor jeder Änderung
63,6 % bedeutet, dass etwa ein Drittel immer noch durchkommt. Wir veröffentlichen diese Zahl, weil die Alternative darin bestünde, eine besser aussehende zu veröffentlichen, die wir nicht verteidigen könnten. Der Benchmark sagt uns auch genau, welches Drittel: ein bearbeiteter Name des Kontoinhabers (0 von 48), Auszüge, die kein Parser liest, eine sorgfältige Bearbeitung, die jede Summe repariert. Diese Liste ist die Roadmap.
Wo uns das hinführt
Bei Holofin ist Dokumentenbetrug eines der Probleme, für die wir bezahlt werden, paranoid zu sein, und die obige Arbeit folgt ein paar Regeln, mit denen wir nicht angefangen haben:
- Ein Urteil beruht auf einem Widerspruch. Anzahlen und Anomalien priorisieren die Warteschlange. Nur ein Dokument, das nicht wahr sein kann, wird verurteilt.
- Jeder Vergleich braucht eine Referenz, oder er enthält sich. Die übereinstimmende Vorlage des Ausstellers oder das, was dieser PDF-Producer normalerweise ausgibt. Andernfalls "nicht geprüft".
- Lesen Sie die Behauptung, nicht nur den Container. Zahlen auf den Cent genau, Daten, die die Bank tatsächlich gedruckt hat, Prüfsummen, Siegel gegen den Schlüssel des Ausstellers, das Aussehen des Ausstellers.
- Vertrauen Sie bei einer Zahl niemals der Textebene. Was eine Seite zeichnet und was sie sagt, kann sich unterscheiden, und zwar absichtlich.
- Messen Sie beide Richtungen. Präzision bei echtem Traffic, Trefferquote bei Fälschungen, vor jeder Änderung.
In der Praxis sind das 92 Signale über Dateistruktur, Typografie, Metadaten, Pixel, kryptografische Siegel und Finanzarithmetik hinweg, von denen jedes in der Lage ist, auf die Seite, die Region und, wenn möglich, das Feld zu verweisen, das fehlgeschlagen ist.
Ein Fälscher kann wegwaschen, wie ein Dokument erstellt wurde, und das, was übrig bleibt, echt aussehen lassen. Was es sagt, muss immer noch wahr sein: auf den Cent genau, gegen den Schlüssel des Ausstellers, im eigenen Look des Ausstellers. Dieser Teil kommt bei der Wäsche nicht heraus.
Verwandte Artikel
Ihr Tabellen-Extraktor hat den Test bestanden. Die Zahlen nicht.
Eine Wirtschaftsprüferin öffnet Ihr Extraktionsergebnis für eine Bilanz. Das Modell zeigt eine Genauigkeit pro Zelle von 99,2 %. Beeindruckend. Dann summiert sie die Aktiva-Spalte von Hand, wie es Prüfer eben tun, und erhält eine Zahl, die um eine Zeile verschoben ist. Die Aktiva entsprechen nicht mehr den Passiva plus Eigenkapital. Die Bilanz geht nicht auf.
Dokumentenbetrug erkennen: Was ein PDF nicht verbergen kann
Früher dachten wir, Dokumentenbetrug sei ein visuelles Problem. Falsche Schriftarten. Verschobene Spalten. Ein Logo, das nicht ganz stimmig wirkte. Wir bauten Prüfungen basierend auf dem, was Menschen sehen, denn das war alles, was wir hatten.
Wenn Dokumente zurückschlagen
Seite 1: Kontoübersicht, zwei Spalten. Seite 15: Dasselbe Konto, drei Spalten, andere Überschriften. Seite 47: Ein Scan mit einem Kaffeefleck. Seite 89: Die Seite mit den Summen, die sich auf Transaktionen beziehen, die Sie vor 70 Seiten extrahiert haben.