
Benchmark
El mejor OCR para documentos financieros en 2026
Cinco motores OCR, 47 extractos bancarios escaneados, 492 importes. Contamos cada importe que leyó cada motor.
 Por Holofin Research
Actualizado 8 min de lectura
Escrito por Holofin, que desarrolla Hologlyph. Todos los motores se ejecutaron sobre los mismos escaneos y se puntuaron con el mismo código. Cómo lo comprobamos
Hologlyph · 491 / 492
99,8%
RapidOCR · 489 / 492
99,4%
docTR · 488 / 492
99,2%
EasyOCR · 456 / 492
92,7%
Tesseract · 437 / 492
88,8%
En esta página
Hologlyph, el OCR que desarrolla Holofin, leyó 491 de 492 importes en 47 extractos bancarios escaneados y leyó completos 46 de los 47 extractos. RapidOCR y docTR, ambos de código abierto, se acercaron con 489 y 488. EasyOCR omitió 36 importes y Tesseract 55, aproximadamente 1 de cada 9.
Puntos clave
- En escaneos, los cinco motores leyeron entre el 88,8 % y el 99,8 % de los importes.
- RapidOCR y docTR son las mejores opciones de código abierto para importes.
- Los errores peligrosos son las lecturas erróneas que siguen pareciendo importes válidos.
El mejor OCR para extractos bancarios: la clasificación
Clasificamos por la proporción de importes leídos, porque un importe es aquello sobre lo que actúa un analista de crédito, un contable o un equipo antifraude. Un extracto cuenta como leído completo cuando se han leído todos sus importes.
| # | Motor | Importes leídos | Extractos leídos completos | Segundos por página | Código abierto | Ideal para |
|---|---|---|---|---|---|---|
| 1 |  Hologlyph (Holofin) | 491 / 492 | 46 / 47 | 0,5 | No | Documentos financieros |
| 2 |  RapidOCR 1.4.4 | 489 / 492 | 44 / 47 | 5,7 | Apache-2.0 | Números, sin PyTorch |
| 3 |  docTR 1.0.1 | 488 / 492 | 45 / 47 | 2,9 | Apache-2.0 | Posición de las palabras |
| 4 | EasyOCR 1.7.2 | 456 / 492 | 24 / 47 | 7,6 | Apache-2.0 | Muchos idiomas |
| 5 | Tesseract 5.3.4 | 437 / 492 | 33 / 47 | 1,1 | Apache-2.0 | Páginas digitales limpias |
Fechas leídas: Hologlyph, RapidOCR y docTR 457 de 492, EasyOCR 453, Tesseract 441. Las fechas se quedan en 457 porque es todo lo que contiene la capa de texto del PDF: algunos extractos imprimen la fecha una sola vez para un grupo de movimientos, o escriben el mes con letras.
Cómo hicimos la prueba
Los extractos. 47 extractos bancarios de 47 bancos, uno por banco: bancos franceses como BNP Paribas, Société Générale, Crédit Agricole y La Banque Postale, bancos alemanes y austriacos, y los neobancos que un prestamista ve en la práctica (Qonto, Revolut, Wise, bunq, Shine, PayPal, SumUp). 93 páginas en total, en francés, alemán e inglés. Todos los extractos se anonimizaron antes de la prueba: nombres, direcciones y números de cuenta sustituidos, y la estructura de las tablas sin cambios.
Los escaneos. Cada página se renderizó a 150 dpi en escala de grises, se giró 0,8 grados, se desenfocó ligeramente, se le añadió ruido de sensor y se guardó como JPEG con calidad 35. Es lo que envía por correo la fotocopiadora de una sucursal, y es para lo que existe el OCR.
Las respuestas. 492 transacciones, cada una con su fecha e importe, verificadas a mano frente al PDF siempre que un sistema evaluado discrepaba de la referencia.
La puntuación. Para cada transacción buscamos su importe en lo que el motor leyó en esa página, dígito a dígito: 1.234,56, 1 234,56 y 1,234.56 cuentan, 1234 no, y cada importe encontrado se usa una sola vez. Una fecha cuenta cuando aparecen su día y su mes. Todos los motores se ejecutaron en CPU, con sus modelos por defecto, y se puntuaron con el mismo código.
La velocidad. Los mismos 10 escaneos, en los mismos 8 núcleos de CPU, un motor cada vez. Hologlyph lee varias páginas a la vez; Tesseract lee una página cada vez por defecto, y es más rápido si se lanzan varias instancias.
1. Hologlyph
Holofin · no es de código abierto
491 de 492 importes, 46 de 47 extractos completos.
Hologlyph es el motor OCR que Holofin desarrolla para los documentos que lee cada día: extractos bancarios, estados financieros, documentos de identidad y los escaneos que los acompañan.
En esta prueba leyó todos los importes que contiene la propia capa de texto del PDF (el que omitió tampoco está en la capa de texto) y fue el más rápido de los cinco. Una advertencia honesta: Hologlyph está entrenado con documentos financieros, por lo que la estructura de estos 47 extractos puede resultarle familiar.
Ideal para: Documentos financieros en los que cada importe debe ser correcto.
2. RapidOCR 1.4.4
Apache-2.0 · CPU, ONNX Runtime · modelos PP-OCRv4
489 de 492 importes, 44 de 47 extractos completos.
RapidOCR empaqueta los modelos PP-OCRv4 de Baidu en ONNX, de modo que se instala con pip y se ejecuta en CPU sin ningún framework de deep learning. Lee líneas enteras de una vez, lo que funciona bien con los números. El precio lo pagan las palabras: en texto latino suele eliminar los espacios, así que RELEVE DE VOTRE COMPTE sale como RELEVEDEVOTRECOMPTE.
También pega elementos vecinos. En un extracto austriaco leyó la fecha contable y el importe como una sola cadena, 24.12.202315.000,00EUR. Un parser que lo interprete como un único número obtiene más de doscientos millones de euros.
Ideal para: Pipelines en CPU sin framework de deep learning, donde los números importan más que las palabras.
3. docTR 1.0.1
Mindee · Apache-2.0 · PyTorch
488 de 492 importes, 45 de 47 extractos completos.
docTR, de Mindee, lee en dos fases: un detector localiza las palabras y un reconocedor las lee. Devuelve cajas de palabras limpias con su posición, lo que lo convierte en el más sencillo de los cinco para construir un parser de tablas. Necesita PyTorch, y leyó completo un extracto más que RapidOCR, aunque omitió un importe más.
Ideal para: Equipos que quieren la posición de las palabras y una API de Python que puedan ajustar (fine-tuning).
4. EasyOCR 1.7.2
JaidedAI · Apache-2.0 · PyTorch
456 de 492 importes, 24 de 47 extractos completos.
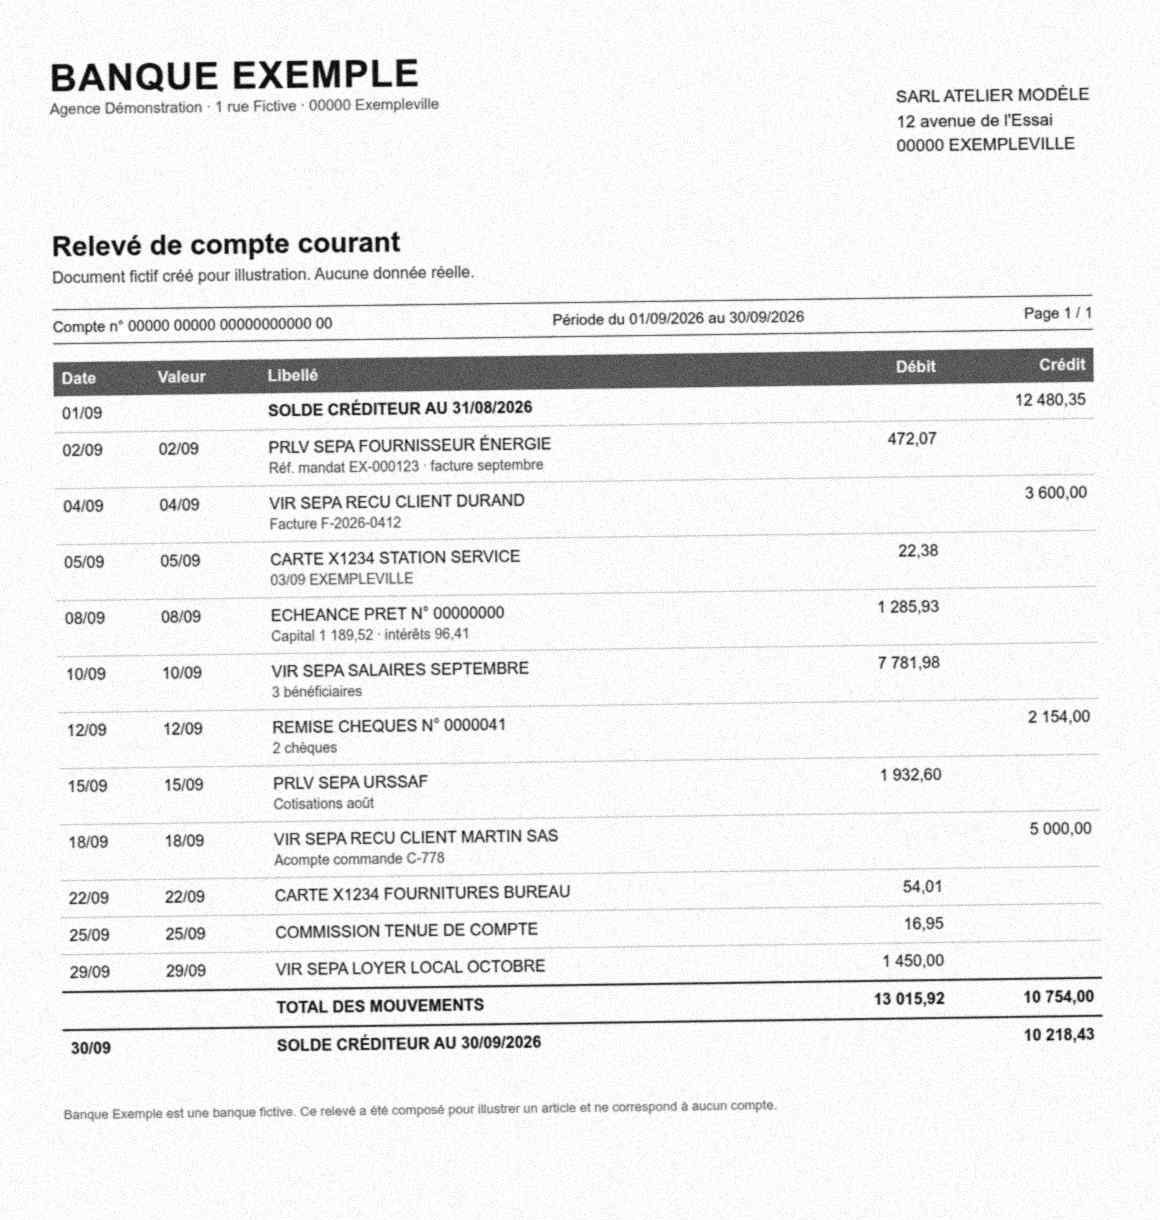
EasyOCR es el más fácil de instalar y lee más de 80 idiomas. En extractos escaneados leyó la mayoría de los importes, pero estropeó los decimales: 7.781,98 se convirtió en 7.78/,98, 50.000,00 en 50.000,oo/ y 25.000,00 en 25,00o 0o. Un cero leído como la letra o es una errata en una frase. En una columna de importes es una transacción que ya no se puede interpretar. También fue el más lento de los cinco.
Ideal para: Texto multilingüe en el que algún error de carácter ocasional es aceptable. No para importes.
5. Tesseract 5.3.4
Apache-2.0 · C++ · funciona en cualquier sitio
437 de 492 importes, 33 de 47 extractos completos.
Tesseract es la respuesta por defecto a "OCR gratuito". En estos escaneos omitió 1 importe de cada 9. Peor que las omisiones son las lecturas erróneas: 472,07 salió como 47207 y 22,38 como 2236. Ambos parecen importes reales. Un número que falta hace que un saldo falle de forma visible. Un número erróneo hace que falle en silencio.
Ideal para: Páginas limpias, nativas digitales, y texto que se va a revisar. No para documentos financieros escaneados.
Lo que una tasa de lectura no le dice
Leer no es extraer
Un motor que lee todos los importes aún no le ha dicho cuál es el cargo, cuál es el abono y cuál es el saldo acumulado. Los extractos ponen las fechas en una línea y los importes en la siguiente, reparten las descripciones en tres líneas y repiten la cabecera en cada página. Convertir el texto en transacciones es una tarea aparte, y es de donde provienen la mayoría de los errores de extracción.
Un importe erróneo parece correcto
Cada lectura errónea anterior es un número válido. 47207 supera cualquier comprobación de formato que haga una hoja de cálculo. Lo único que lo detecta es la aritmética: el saldo inicial más las transacciones debe ser igual al saldo final. Si su pipeline no hace esa suma, no sabe si su OCR ha funcionado.
El OCR lee igual de bien un extracto falsificado
Un OCR perfecto lee un extracto editado con la misma fidelidad que uno auténtico. Si el PDF se modificó después de que lo generara el banco, o si una página fue redibujada por un modelo de imagen, es una pregunta que el OCR no se hace.
Cómo elegir un OCR para documentos financieros
- Pruebe con sus propios escaneos, no con PDF limpios: en los escaneos es donde los motores se diferencian.
- Cuente importes, no caracteres. Una precisión del 99 % por carácter oculta el único carácter que desplaza una coma decimal.
- Compruebe si endereza la página. Una fotocopiadora gira las páginas un grado aproximadamente, y una línea torcida coloca el importe en la fila equivocada.
- Mantenga los números enteros. Un motor que corta
15 000,00entre sus grupos, o lo pega a la fecha de al lado, entrega a su parser un número distinto. - Concilie después de leer. El saldo inicial más las transacciones es igual al saldo final; si no, el extracto pasa a revisión humana.
En Holofin, leer la página es el primer paso, no el producto. Cada extracto bancario se lee, se convierte en transacciones y se concilia: el saldo inicial más las transacciones debe ser igual al saldo final con un margen de 0,02 EUR. Cada PDF pasa por más de 100 controles forenses de fraude, los documentos permanecen en la UE y cuesta desde 0,05 EUR por página.
Fuentes
- RapidOCR 1.4.4
- docTR 1.0.1
- EasyOCR 1.7.2
- Tesseract 5.3.4
- PaddleOCR (PP-OCRv4)
- Benchmark de extracción de extractos bancarios
¿Ha detectado un error? Escriba a [email protected] y repetiremos la prueba y anotaremos el cambio.
Preguntas frecuentes
¿Cuál es el mejor OCR para extractos bancarios?
En nuestra prueba, Hologlyph leyó 491 de 492 importes en 47 extractos escaneados. Entre los motores de código abierto, RapidOCR (489) y docTR (488) quedaron muy cerca, muy por delante de EasyOCR (456) y Tesseract (437).
¿Cuál es el mejor OCR de código abierto para extractos bancarios?
RapidOCR y docTR, ambos con licencia Apache-2.0. RapidOCR leyó 489 de 492 importes y no necesita ningún framework de deep learning; docTR leyó 488, leyó completos 45 de 47 extractos y fue el doble de rápido en nuestra prueba en CPU.
Tesseract vs EasyOCR vs docTR: ¿cuál lee mejor los extractos bancarios?
docTR, con gran diferencia: 488 importes frente a 456 de EasyOCR y 437 de Tesseract, y 45 extractos leídos completos frente a 24 y 33. Tesseract fue el más rápido de los tres, con 1,1 segundos por página.
¿Es Tesseract suficiente para documentos financieros?
Para extractos escaneados, no. Omitió 55 de 492 importes y convirtió algunos en otros números de aspecto válido, como 47207 en lugar de 472,07.
¿Qué precisión tiene el OCR en extractos bancarios escaneados?
En nuestros escaneos, los cinco motores leyeron entre el 88,8 % y el 99,8 % de los importes. Ni siquiera un 99 % basta por sí solo: un importe mal leído en un extracto de tres meses significa que los saldos ya no cuadran.
¿Necesito una GPU para el OCR?
No. Los cinco motores de esta prueba se ejecutaron en CPU, y RapidOCR no necesita ningún framework de deep learning.
¿Es Hologlyph de código abierto?
No. Es el motor OCR que Holofin desarrolla para los documentos que procesa.
¿Cómo puedo solicitar la corrección de un resultado?
Escriba a [email protected] indicando el motor, su versión y lo que ha medido. Repetiremos la prueba, corregiremos la fila y actualizaremos la fecha.
Pruebe Holofin con sus propios documentos.
Cada valor vinculado a la página de la que procede, cada PDF revisado contra manipulaciones, reglas comprobadas en todo el expediente.