
Benchmark
Le meilleur OCR pour les documents financiers en 2026
Cinq moteurs OCR, 47 relevés bancaires scannés, 492 montants. Nous avons compté chaque montant lu par chaque moteur.
 Par Holofin Research
Mis à jour le 8 min de lecture
Rédigé par Holofin, qui développe Hologlyph. Chaque moteur a tourné sur les mêmes scans et a été noté par le même code. Notre méthode de vérification
Hologlyph · 491 / 492
99,8 %
RapidOCR · 489 / 492
99,4 %
docTR · 488 / 492
99,2 %
EasyOCR · 456 / 492
92,7 %
Tesseract · 437 / 492
88,8 %
Sur cette page
Hologlyph, l'OCR développé par Holofin, a lu 491 sur 492 montants sur 47 relevés bancaires scannés et a lu 46 relevés sur 47 en entier. RapidOCR et docTR, tous deux open source, suivent de près avec 489 et 488. EasyOCR a manqué 36 montants et Tesseract 55, soit environ 1 sur 9.
À retenir
- Sur des scans, les cinq moteurs ont lu entre 88,8 % et 99,8 % des montants.
- RapidOCR et docTR sont les meilleurs choix open source pour les montants.
- Les erreurs dangereuses sont les mauvaises lectures qui ressemblent encore à des montants valides.
Meilleur OCR pour relevés bancaires : le classement
Nous classons selon la part des montants lus, car c'est sur un montant qu'agissent un analyste crédit, un comptable ou une équipe fraude. Un relevé est considéré comme lu en entier quand chacun de ses montants a été lu.
| # | Moteur | Montants lus | Relevés lus en entier | Secondes par page | Open source | Idéal pour |
|---|---|---|---|---|---|---|
| 1 |  Hologlyph (Holofin) | 491 / 492 | 46 / 47 | 0,5 | Non | Documents financiers |
| 2 |  RapidOCR 1.4.4 | 489 / 492 | 44 / 47 | 5,7 | Apache-2.0 | Chiffres, sans PyTorch |
| 3 |  docTR 1.0.1 | 488 / 492 | 45 / 47 | 2,9 | Apache-2.0 | Positions des mots |
| 4 | EasyOCR 1.7.2 | 456 / 492 | 24 / 47 | 7,6 | Apache-2.0 | Nombreuses langues |
| 5 | Tesseract 5.3.4 | 437 / 492 | 33 / 47 | 1,1 | Apache-2.0 | Pages numériques propres |
Dates lues : Hologlyph, RapidOCR et docTR 457 sur 492, EasyOCR 453, Tesseract 441. Les dates plafonnent à 457, car c'est tout ce que la couche texte du PDF contient : certains relevés n'impriment la date qu'une fois pour un groupe d'opérations, ou écrivent le mois en toutes lettres.
Notre méthode de test
Les relevés. 47 relevés bancaires de 47 banques, un par banque : des banques françaises comme BNP Paribas, Société Générale, Crédit Agricole et La Banque Postale, des banques allemandes et autrichiennes, et les néobanques qu'un prêteur voit réellement passer (Qonto, Revolut, Wise, bunq, Shine, PayPal, SumUp). 93 pages au total, en français, allemand et anglais. Chaque relevé a été anonymisé avant le test : noms, adresses et numéros de compte remplacés, mise en page des tableaux inchangée.
Les scans. Chaque page a été rendue à 150 dpi en niveaux de gris, pivotée de 0,8 degré, légèrement floutée, bruitée comme par un capteur et enregistrée en JPEG qualité 35. C'est ce qu'envoie par e-mail le copieur d'une agence, et c'est pour cela que l'OCR existe.
Les réponses. 492 transactions, chacune avec sa date et son montant, vérifiées à la main par rapport au PDF chaque fois qu'un système testé divergeait de la référence.
Le score. Pour chaque transaction, nous cherchons son montant dans ce que le moteur a lu sur la page, chiffre par chiffre : 1.234,56, 1 234,56 et 1,234.56 comptent tous, 1234 ne compte pas, et chaque montant trouvé n'est utilisé qu'une fois. Une date compte quand son jour et son mois sont présents. Chaque moteur a tourné sur CPU, avec ses modèles par défaut, et a été noté par le même code.
La vitesse. Les mêmes 10 scans, sur les mêmes 8 cœurs CPU, un moteur à la fois. Hologlyph lit plusieurs pages à la fois ; Tesseract lit une page à la fois par défaut, et va plus vite si vous lancez plusieurs instances.
1. Hologlyph
Holofin · pas open source
491 sur 492 montants, 46 sur 47 relevés lus en entier.
Hologlyph est le moteur OCR que Holofin développe pour les documents qu'il lit chaque jour : relevés bancaires, états financiers, pièces d'identité et les scans qui les accompagnent.
Sur ce test, il a lu chaque montant présent dans la couche texte du PDF (celui qu'il a manqué est aussi absent de la couche texte), et il a été le plus rapide des cinq. Une mise en garde honnête : Hologlyph est entraîné sur des documents financiers, les mises en page de ces 47 relevés peuvent donc lui être familières.
Idéal pour : Les documents financiers où chaque montant doit être juste.
2. RapidOCR 1.4.4
Apache-2.0 · CPU, ONNX Runtime · modèles PP-OCRv4
489 sur 492 montants, 44 sur 47 relevés lus en entier.
RapidOCR intègre les modèles PP-OCRv4 de Baidu au format ONNX : il s'installe avec pip et tourne sur CPU sans framework de deep learning. Il lit des lignes entières d'un coup, ce qui fonctionne bien sur les chiffres. Le prix à payer porte sur les mots : sur du texte latin, il supprime souvent les espaces, si bien que RELEVE DE VOTRE COMPTE devient RELEVEDEVOTRECOMPTE.
Il colle aussi les éléments voisins. Sur un relevé autrichien, il a lu la date de comptabilisation et le montant comme une seule chaîne, 24.12.202315.000,00EUR. Un parseur qui lit cela comme un seul nombre obtient plus de deux cents millions d'euros.
Idéal pour : Pipelines CPU sans framework de deep learning, où les chiffres comptent plus que les mots.
3. docTR 1.0.1
Mindee · Apache-2.0 · PyTorch
488 sur 492 montants, 45 sur 47 relevés lus en entier.
docTR, de Mindee, lit en deux étapes : un détecteur trouve les mots, un modèle de reconnaissance les lit. Il renvoie des boîtes de mots propres avec leurs positions, ce qui en fait le plus simple des cinq pour construire un parseur de tableaux. Il nécessite PyTorch, et il a lu un relevé de plus en entier que RapidOCR, tout en manquant un montant de plus.
Idéal pour : Les équipes qui veulent les positions des mots et une API Python qu'elles peuvent affiner.
4. EasyOCR 1.7.2
JaidedAI · Apache-2.0 · PyTorch
456 sur 492 montants, 24 sur 47 relevés lus en entier.
EasyOCR est le plus simple à installer et lit plus de 80 langues. Sur les relevés scannés, il a lu la plupart des montants mais a abîmé les décimales : 7.781,98 est devenu 7.78/,98, 50.000,00 est devenu 50.000,oo/, et 25.000,00 est devenu 25,00o 0o. Un zéro lu comme la lettre o, c'est une coquille dans une phrase. Dans une colonne de montants, c'est une transaction qui ne se parse plus. Il a aussi été le plus lent des cinq.
Idéal pour : Texte multilingue où une erreur de caractère occasionnelle est acceptable. Pas les montants.
5. Tesseract 5.3.4
Apache-2.0 · C++ · tourne partout
437 sur 492 montants, 33 sur 47 relevés lus en entier.
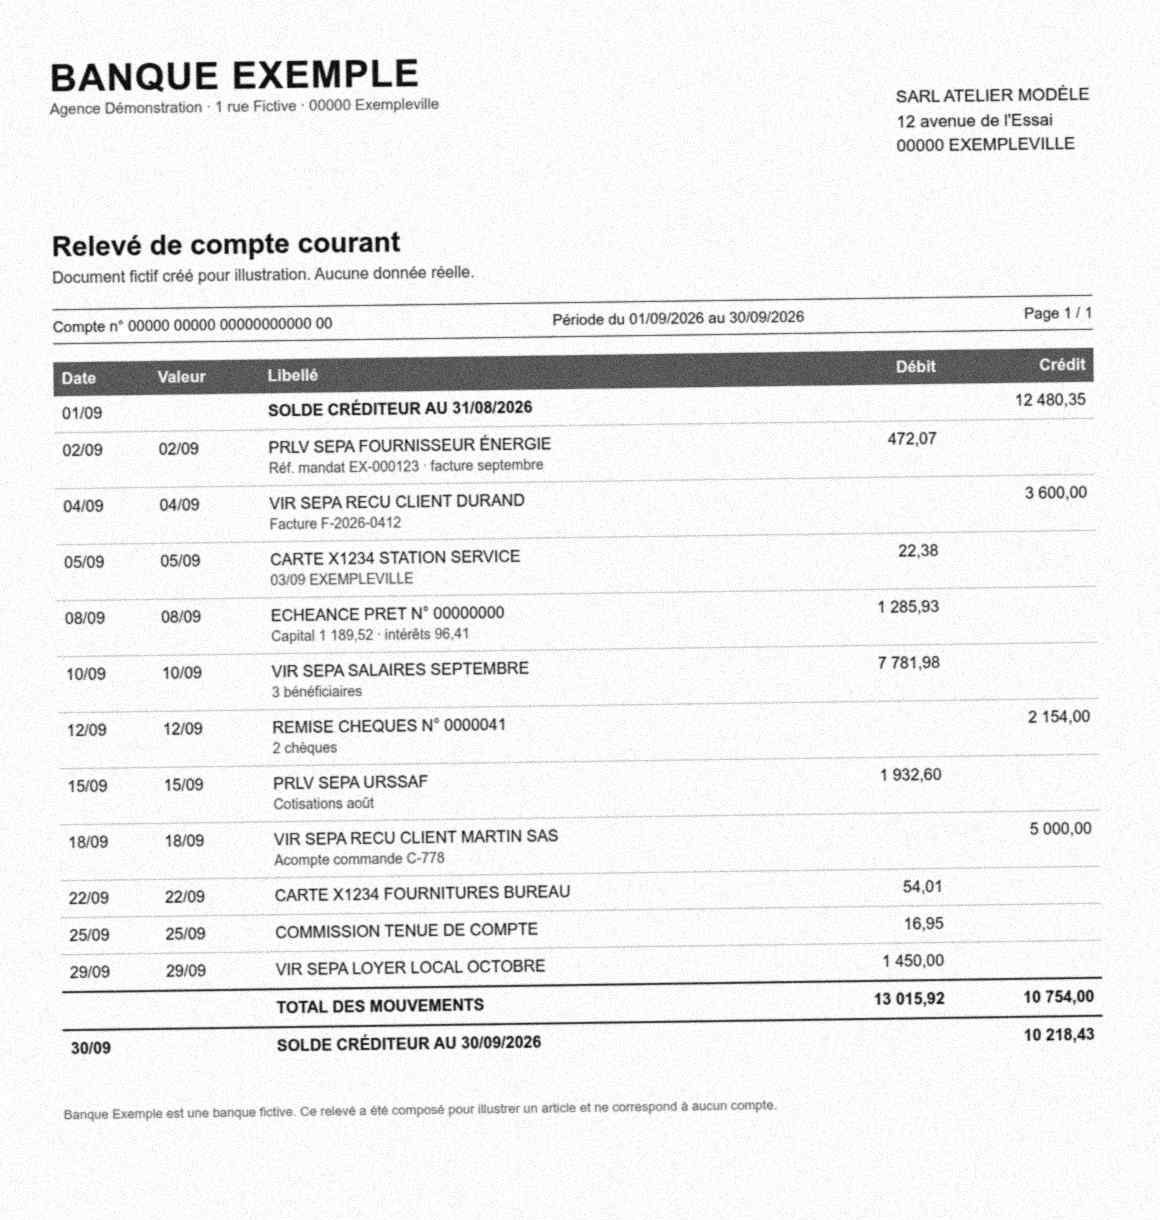
Tesseract est la réponse par défaut à « OCR gratuit ». Sur ces scans, il a manqué 1 montant sur 9. Pire que les oublis, les mauvaises lectures : 472,07 est ressorti en 47207 et 22,38 en 2236. Les deux ressemblent à de vrais montants. Un nombre manquant fait échouer un solde bruyamment. Un nombre faux le fait échouer en silence.
Idéal pour : Pages propres, nativement numériques, et texte que vous relirez. Pas les documents financiers scannés.
Ce que le taux de lecture ne dit pas
Lire n'est pas extraire
Un moteur qui lit chaque montant ne vous a toujours pas dit quel montant est le débit, lequel est le crédit et lequel est le solde courant. Les mises en page de relevés placent les dates sur une ligne et les montants sur la suivante, répartissent les libellés sur trois lignes et répètent l'en-tête sur chaque page. Transformer le texte en transactions est un travail distinct, et c'est là que naissent la plupart des erreurs d'extraction.
Un montant faux ressemble à un montant juste
Chaque mauvaise lecture ci-dessus est un nombre valide. 47207 passe tous les contrôles de format qu'un tableur effectuera. Seule l'arithmétique le détecte : le solde d'ouverture plus les transactions doit être égal au solde de clôture. Si votre pipeline ne fait pas cette somme, il ne sait pas si son OCR a fonctionné.
L'OCR lit tout aussi bien un relevé falsifié
Un OCR parfait lit un relevé modifié aussi fidèlement qu'un relevé authentique. Savoir si le PDF a été modifié après sa production par la banque, ou si une page a été redessinée par un modèle d'image, est une question que l'OCR ne se pose pas.
Comment choisir un OCR pour les documents financiers
- Testez sur vos propres scans, pas sur des PDF propres : c'est sur les scans que les moteurs se départagent.
- Comptez les montants, pas les caractères. Une précision de 99 % par caractère cache le seul caractère qui déplace une virgule.
- Vérifiez s'il redresse la page. Un copieur fait pivoter les pages d'un degré environ, et une ligne inclinée place le montant sur la mauvaise ligne.
- Gardez les nombres entiers. Un moteur qui coupe
15 000,00entre ses groupes, ou le colle à la date voisine, transmet un autre nombre à votre parseur. - Rapprochez après la lecture. Le solde d'ouverture plus les transactions égale le solde de clôture, sinon le relevé est transmis à une personne.
Chez Holofin, lire la page est la première étape, pas le produit. Chaque relevé bancaire est lu, transformé en transactions et rapproché : le solde d'ouverture plus les transactions doit être égal au solde de clôture à 0,02 EUR près. Chaque PDF passe par plus de 100 contrôles forensiques de fraude, les documents restent dans l'UE, et le tout coûte à partir de 0,05 EUR par page.
Sources
- RapidOCR 1.4.4
- docTR 1.0.1
- EasyOCR 1.7.2
- Tesseract 5.3.4
- PaddleOCR (PP-OCRv4)
- Benchmark d'extraction de relevés bancaires
Une erreur ? Écrivez à [email protected] et nous relancerons le test et noterons le changement.
Questions fréquentes
Quel est le meilleur OCR pour les relevés bancaires ?
Lors de notre test, Hologlyph a lu 491 sur 492 montants sur 47 relevés scannés. Parmi les moteurs open source, RapidOCR (489) et docTR (488) suivent de près, loin devant EasyOCR (456) et Tesseract (437).
Quel est le meilleur OCR open source pour les relevés bancaires ?
RapidOCR et docTR, tous deux sous Apache-2.0. RapidOCR a lu 489 sur 492 montants et ne nécessite aucun framework de deep learning ; docTR en a lu 488, a lu 45 relevés sur 47 en entier et a été deux fois plus rapide lors de notre test sur CPU.
Tesseract vs EasyOCR vs docTR : lequel lit le mieux les relevés bancaires ?
docTR, de loin : 488 montants contre 456 pour EasyOCR et 437 pour Tesseract, et 45 relevés lus en entier contre 24 et 33. Tesseract a été le plus rapide des trois, avec 1,1 seconde par page.
Tesseract est-il suffisant pour les documents financiers ?
Pour des relevés scannés, non. Il a manqué 55 montants sur 492 et en a transformé certains en d'autres nombres d'apparence valide, comme 47207 pour 472,07.
Quelle est la précision de l'OCR sur des relevés bancaires scannés ?
Sur nos scans, les cinq moteurs ont lu entre 88,8 % et 99,8 % des montants. Même 99 % ne suffit pas à lui seul : un seul montant mal lu dans un relevé de trois mois, et les soldes ne concordent plus.
Faut-il un GPU pour l'OCR ?
Non. Les cinq moteurs de ce test ont tourné sur CPU, et RapidOCR ne nécessite aucun framework de deep learning.
Hologlyph est-il open source ?
Non. C'est le moteur OCR que Holofin développe pour les documents qu'il traite.
Comment faire corriger un résultat ?
Écrivez à [email protected] en indiquant le moteur, sa version et ce que vous avez mesuré. Nous relançons le test, corrigeons la ligne et mettons à jour la date.
Testez Holofin sur vos propres documents.
Chaque valeur reliée à sa position sur la page, chaque PDF analysé pour détecter les falsifications, des règles appliquées à l'ensemble du dossier.