
Benchmark
Die beste OCR für Finanzdokumente 2026
Fünf OCR-Engines, 47 gescannte Kontoauszüge, 492 Beträge. Wir haben jeden Betrag gezählt, den jede Engine gelesen hat.
 Von Holofin Research
Aktualisiert 8 Min. Lesezeit
Verfasst von Holofin, dem Entwickler von Hologlyph. Jede Engine lief auf denselben Scans und wurde vom selben Code bewertet. So haben wir geprüft
Hologlyph · 491 / 492
99,8%
RapidOCR · 489 / 492
99,4%
docTR · 488 / 492
99,2%
EasyOCR · 456 / 492
92,7%
Tesseract · 437 / 492
88,8%
Auf dieser Seite
Hologlyph, die OCR, die Holofin entwickelt, las 491 von 492 Beträgen auf 47 gescannten Kontoauszügen und las 46 von 47 Kontoauszügen vollständig. RapidOCR und docTR, beide Open Source, kamen mit 489 und 488 nahe heran. EasyOCR verpasste 36 Beträge und Tesseract 55, etwa jeden neunten.
Das Wichtigste in Kürze
- Auf Scans lasen die fünf Engines zwischen 88,8 % und 99,8 % der Beträge.
- RapidOCR und docTR sind bei Beträgen die beste Open-Source-Wahl.
- Die gefährlichen Fehler sind Fehllesungen, die trotzdem wie gültige Beträge aussehen.
Beste OCR für Kontoauszüge: die Rangliste
Wir ordnen nach dem Anteil gelesener Beträge, denn auf Grundlage eines Betrags handeln Kreditanalysten, Buchhalter und Betrugsteams. Ein Kontoauszug gilt als vollständig gelesen, wenn jeder seiner Beträge gelesen wurde.
| # | Engine | Gelesene Beträge | Vollständig gelesene Kontoauszüge | Sekunden pro Seite | Open Source | Am besten für |
|---|---|---|---|---|---|---|
| 1 |  Hologlyph (Holofin) | 491 / 492 | 46 / 47 | 0,5 | Nein | Finanzdokumente |
| 2 |  RapidOCR 1.4.4 | 489 / 492 | 44 / 47 | 5,7 | Apache-2.0 | Zahlen, ohne PyTorch |
| 3 |  docTR 1.0.1 | 488 / 492 | 45 / 47 | 2,9 | Apache-2.0 | Wortpositionen |
| 4 | EasyOCR 1.7.2 | 456 / 492 | 24 / 47 | 7,6 | Apache-2.0 | Viele Sprachen |
| 5 | Tesseract 5.3.4 | 437 / 492 | 33 / 47 | 1,1 | Apache-2.0 | Saubere digitale Seiten |
Gelesene Daten: Hologlyph, RapidOCR und docTR 457 von 492, EasyOCR 453, Tesseract 441. Bei 457 ist Schluss, weil die Textebene des PDFs nicht mehr hergibt: Manche Kontoauszüge drucken ein Datum nur einmal für eine Gruppe von Buchungen oder schreiben den Monat aus.
So haben wir getestet
Die Kontoauszüge. 47 Kontoauszüge von 47 Banken, einer pro Bank: französische Banken wie BNP Paribas, Société Générale, Crédit Agricole und La Banque Postale, deutsche und österreichische Banken sowie die Neobanken, die ein Kreditgeber tatsächlich sieht (Qonto, Revolut, Wise, bunq, Shine, PayPal, SumUp). Insgesamt 93 Seiten, auf Französisch, Deutsch und Englisch. Jeder Kontoauszug wurde vor dem Test anonymisiert: Namen, Adressen und Kontonummern ersetzt, das Tabellenlayout unverändert.
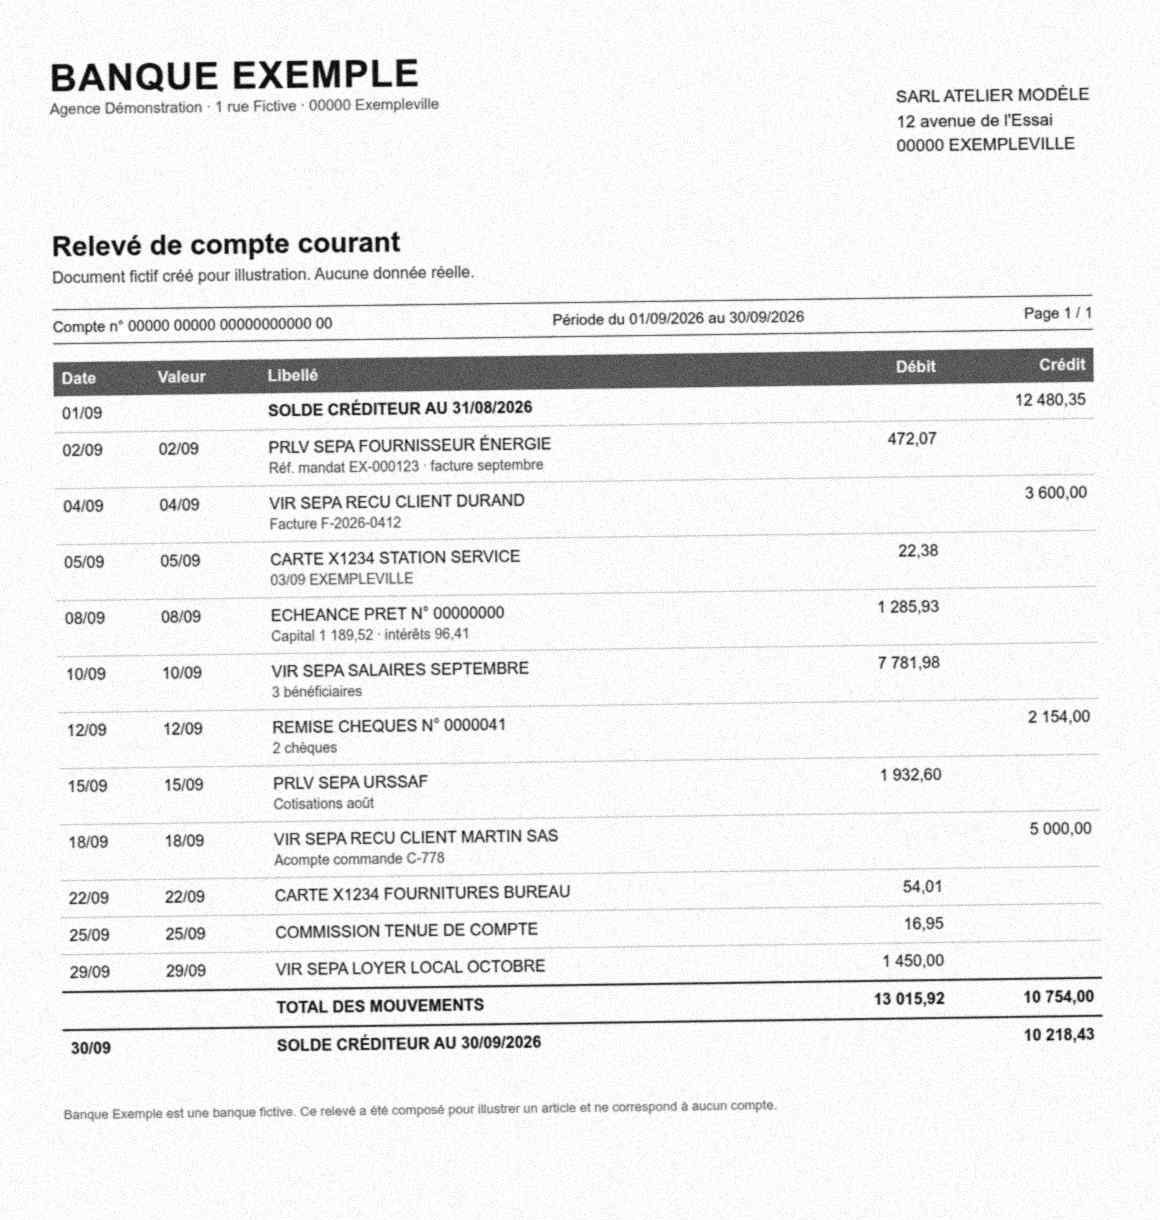
Die Scans. Jede Seite wurde mit 150 dpi in Graustufen gerendert, um 0,8 Grad gedreht, leicht weichgezeichnet, mit Sensorrauschen versehen und als JPEG mit Qualität 35 gespeichert. So sieht aus, was ein Filialkopierer per E-Mail verschickt, und genau dafür gibt es OCR.
Die Referenz. 492 Transaktionen, jede mit Datum und Betrag, von Hand am PDF geprüft, wo immer ein getestetes System von der Referenz abwich.
Die Bewertung. Für jede Transaktion suchen wir ihren Betrag in dem, was die Engine auf dieser Seite gelesen hat, Ziffer für Ziffer: 1.234,56, 1 234,56 und 1,234.56 zählen alle, 1234 nicht, und jeder gefundene Betrag wird nur einmal verwendet. Ein Datum zählt, wenn Tag und Monat vorhanden sind. Jede Engine lief auf CPU, mit ihren Standardmodellen, und wurde vom selben Code bewertet.
Die Geschwindigkeit. Dieselben 10 Scans, auf denselben 8 CPU-Kernen, eine Engine nach der anderen. Hologlyph liest mehrere Seiten gleichzeitig; Tesseract liest standardmäßig eine Seite nach der anderen und läuft schneller, wenn Sie mehrere Instanzen starten.
1. Hologlyph
Holofin · nicht Open Source
491 von 492 Beträgen, 46 von 47 Kontoauszügen vollständig.
Hologlyph ist die OCR-Engine, die Holofin für die Dokumente entwickelt, die es täglich liest: Kontoauszüge, Jahresabschlüsse, Ausweisdokumente und die Scans, die dazugehören.
In diesem Test las sie jeden Betrag, den die eigene Textebene des PDFs enthält (der eine Betrag, den sie verpasste, fehlt auch in der Textebene), und sie war die schnellste der fünf. Ein fairer Hinweis: Hologlyph ist auf Finanzdokumente trainiert, die Layouts dieser 47 Kontoauszüge könnten ihr daher vertraut sein.
Am besten für: Finanzdokumente, bei denen jeder Betrag stimmen muss.
2. RapidOCR 1.4.4
Apache-2.0 · CPU, ONNX Runtime · PP-OCRv4-Modelle
489 von 492 Beträgen, 44 von 47 Kontoauszügen vollständig.
RapidOCR verpackt die PP-OCRv4-Modelle von Baidu in ONNX, sodass es sich per pip installieren lässt und ohne Deep-Learning-Framework auf CPU läuft. Es liest ganze Zeilen auf einmal, was bei Zahlen gut funktioniert. Der Preis zeigt sich bei den Wörtern: Bei lateinischem Text lässt es oft die Leerzeichen weg, sodass RELEVE DE VOTRE COMPTE als RELEVEDEVOTRECOMPTE zurückkommt.
Außerdem klebt es Nachbarn zusammen. Auf einem österreichischen Kontoauszug las es Buchungsdatum und Betrag als eine Zeichenkette, 24.12.202315.000,00EUR. Ein Parser, der das als eine Zahl liest, erhält mehr als zweihundert Millionen Euro.
Am besten für: CPU-Pipelines ohne Deep-Learning-Framework, bei denen Zahlen wichtiger sind als Wörter.
3. docTR 1.0.1
Mindee · Apache-2.0 · PyTorch
488 von 492 Beträgen, 45 von 47 Kontoauszügen vollständig.
docTR von Mindee liest in zwei Stufen: Ein Detektor findet die Wörter, ein Erkennungsmodell liest sie. Es liefert saubere Wortboxen mit ihren Positionen und ist damit unter den fünf die einfachste Grundlage für einen Tabellenparser. Es benötigt PyTorch und las einen Kontoauszug mehr vollständig als RapidOCR, verpasste aber auch einen Betrag mehr.
Am besten für: Teams, die Wortpositionen und eine Python-API zum Feintuning wollen.
4. EasyOCR 1.7.2
JaidedAI · Apache-2.0 · PyTorch
456 von 492 Beträgen, 24 von 47 Kontoauszügen vollständig.
EasyOCR ist am einfachsten zu installieren und liest mehr als 80 Sprachen. Auf gescannten Kontoauszügen las es die meisten Beträge, verstümmelte aber die Dezimalstellen: 7.781,98 wurde zu 7.78/,98, 50.000,00 zu 50.000,oo/ und 25.000,00 zu 25,00o 0o. Eine Null, die als Buchstabe o gelesen wird, ist in einem Satz ein Tippfehler. In einer Betragsspalte ist sie eine Transaktion, die sich nicht mehr parsen lässt. Es war außerdem die langsamste der fünf Engines.
Am besten für: Mehrsprachiger Text, bei dem gelegentliche Zeichenfehler kein Problem sind. Keine Beträge.
5. Tesseract 5.3.4
Apache-2.0 · C++ · läuft überall
437 von 492 Beträgen, 33 von 47 Kontoauszügen vollständig.
Tesseract ist die Standardantwort auf „kostenlose OCR“. Auf diesen Scans verpasste es jeden neunten Betrag. Schlimmer als die Auslassungen sind die Fehllesungen: 472,07 kam als 47207 zurück und 22,38 als 2236. Beide sehen wie echte Beträge aus. Eine fehlende Zahl lässt die Saldenprüfung sichtbar scheitern. Eine falsche Zahl lässt sie unbemerkt scheitern.
Am besten für: Saubere, digital erzeugte Seiten und Text, den Sie Korrektur lesen. Keine gescannten Finanzdokumente.
Was eine Leserate nicht verrät
Lesen ist nicht Extrahieren
Eine Engine, die jeden Betrag liest, hat Ihnen noch nicht gesagt, welcher Betrag die Belastung, welcher die Gutschrift und welcher der laufende Saldo ist. Kontoauszugslayouts setzen Daten in eine Zeile und Beträge in die nächste, verteilen Beschreibungen über drei Zeilen und wiederholen den Tabellenkopf auf jeder Seite. Den Text in Transaktionen umzuwandeln ist eine eigene Aufgabe, und dort entstehen die meisten Extraktionsfehler.
Ein falscher Betrag sieht aus wie ein richtiger
Jede der obigen Fehllesungen ist eine gültige Zahl. 47207 besteht jede Formatprüfung, die eine Tabellenkalkulation durchführt. Das Einzige, was sie erkennt, ist Arithmetik: Anfangssaldo plus Transaktionen muss den Endsaldo ergeben. Wenn Ihre Pipeline diese Summe nicht bildet, weiß sie nicht, ob ihre OCR funktioniert hat.
OCR liest einen gefälschten Kontoauszug genauso gut
Eine perfekte OCR liest einen bearbeiteten Kontoauszug so getreu wie einen echten. Ob das PDF verändert wurde, nachdem die Bank es erstellt hat, oder ob eine Seite von einem Bildmodell neu gezeichnet wurde, ist eine Frage, die OCR nicht stellt.
So wählen Sie eine OCR für Finanzdokumente
- Testen Sie mit Ihren eigenen Scans, nicht mit sauberen PDFs: Bei Scans trennen sich die Engines.
- Zählen Sie Beträge, nicht Zeichen. Eine Zeichengenauigkeit von 99 % verbirgt das eine Zeichen, das ein Dezimalkomma verschiebt.
- Prüfen Sie, ob die Engine die Seite gerade ausrichtet. Ein Kopierer dreht Seiten um etwa ein Grad, und eine schiefe Zeile setzt den Betrag in die falsche Zeile.
- Halten Sie Zahlen zusammen. Eine Engine, die
15 000,00zwischen den Zifferngruppen trennt oder an das Datum daneben klebt, übergibt Ihrem Parser eine andere Zahl. - Gleichen Sie nach dem Lesen ab. Anfangssaldo plus Transaktionen ergibt den Endsaldo, oder der Kontoauszug geht an einen Menschen.
Bei Holofin ist das Lesen der Seite der erste Schritt, nicht das Produkt. Jeder Kontoauszug wird gelesen, in Transaktionen umgewandelt und abgeglichen: Anfangssaldo plus Transaktionen muss auf 0,02 EUR genau den Endsaldo ergeben. Jedes PDF durchläuft mehr als 100 forensische Betrugsprüfungen, die Dokumente bleiben in der EU, und es kostet ab 0,05 EUR pro Seite.
Quellen
- RapidOCR 1.4.4
- docTR 1.0.1
- EasyOCR 1.7.2
- Tesseract 5.3.4
- PaddleOCR (PP-OCRv4)
- Benchmark zur Kontoauszug-Extraktion
Einen Fehler entdeckt? Schreiben Sie an [email protected] und wir wiederholen den Test und vermerken die Änderung.
Häufig gestellte Fragen
Was ist die beste OCR für Kontoauszüge?
In unserem Test las Hologlyph 491 von 492 Beträgen auf 47 gescannten Kontoauszügen. Unter den Open-Source-Engines lagen RapidOCR (489) und docTR (488) knapp dahinter, deutlich vor EasyOCR (456) und Tesseract (437).
Was ist die beste Open-Source-OCR für Kontoauszüge?
RapidOCR und docTR, beide Apache-2.0. RapidOCR las 489 von 492 Beträgen und braucht kein Deep-Learning-Framework; docTR las 488, las 45 von 47 Kontoauszügen vollständig und war in unserem CPU-Test doppelt so schnell.
Tesseract vs EasyOCR vs docTR: Welche Engine liest Kontoauszüge am besten?
docTR, mit großem Abstand: 488 Beträge gegenüber 456 bei EasyOCR und 437 bei Tesseract, und 45 vollständig gelesene Kontoauszüge gegenüber 24 und 33. Tesseract war mit 1,1 Sekunden pro Seite die schnellste der drei.
Ist Tesseract gut genug für Finanzdokumente?
Für gescannte Kontoauszüge nicht. Tesseract verpasste 55 von 492 Beträgen und machte aus manchen andere, gültig aussehende Zahlen, etwa 47207 aus 472,07.
Wie genau ist OCR auf gescannten Kontoauszügen?
Auf unseren Scans lasen die fünf Engines zwischen 88,8 % und 99,8 % der Beträge. Selbst 99 % reichen allein nicht aus: Ein falsch gelesener Betrag in einem Dreimonatsauszug bedeutet, dass die Salden nicht mehr aufgehen.
Brauche ich eine GPU für OCR?
Nein. Alle fünf Engines in diesem Test liefen auf CPU, und RapidOCR braucht überhaupt kein Deep-Learning-Framework.
Ist Hologlyph Open Source?
Nein. Es ist die OCR-Engine, die Holofin für die Dokumente entwickelt, die es verarbeitet.
Wie lasse ich ein Ergebnis korrigieren?
Schreiben Sie an [email protected] mit der Engine, ihrer Version und Ihrem Messergebnis. Wir wiederholen den Test, korrigieren die Zeile und aktualisieren das Datum.
Testen Sie Holofin mit Ihren eigenen Dokumenten.
Jeder Wert mit der Seite verknüpft, von der er stammt, jedes PDF auf Manipulation geprüft, Regeln über die gesamte Fallakte geprüft.