
Benchmark
Il miglior OCR per documenti finanziari nel 2026
Cinque motori OCR, 47 estratti conto scansionati, 492 importi. Abbiamo contato ogni importo letto da ciascun motore.
 Di Holofin Research
Aggiornato 8 min di lettura
Scritto da Holofin, che sviluppa Hologlyph. Ogni motore è stato eseguito sulle stesse scansioni e valutato dallo stesso codice. Come abbiamo verificato
Hologlyph · 491 / 492
99,8%
RapidOCR · 489 / 492
99,4%
docTR · 488 / 492
99,2%
EasyOCR · 456 / 492
92,7%
Tesseract · 437 / 492
88,8%
In questa pagina
Hologlyph, l'OCR sviluppato da Holofin, ha letto 491 importi su 492 su 47 estratti conto scansionati e ha letto per intero 46 estratti conto su 47. RapidOCR e docTR, entrambi open source, si sono avvicinati con 489 e 488. EasyOCR ha mancato 36 importi e Tesseract 55, circa 1 su 9.
Punti chiave
- Sulle scansioni, i cinque motori hanno letto tra l'88,8% e il 99,8% degli importi.
- RapidOCR e docTR sono le migliori scelte open source per gli importi.
- Gli errori pericolosi sono le letture errate che sembrano ancora importi validi.
Miglior OCR per estratti conto: la classifica
Classifichiamo in base alla quota di importi letti, perché l'importo è ciò su cui agisce un analista del credito, un contabile o un team antifrode. Un estratto conto conta come letto per intero quando ogni suo importo è stato letto.
| # | Motore | Importi letti | Estratti conto letti per intero | Secondi per pagina | Open source | Ideale per |
|---|---|---|---|---|---|---|
| 1 |  Hologlyph (Holofin) | 491 / 492 | 46 / 47 | 0,5 | No | Documenti finanziari |
| 2 |  RapidOCR 1.4.4 | 489 / 492 | 44 / 47 | 5,7 | Apache-2.0 | Numeri, senza PyTorch |
| 3 |  docTR 1.0.1 | 488 / 492 | 45 / 47 | 2,9 | Apache-2.0 | Posizioni delle parole |
| 4 | EasyOCR 1.7.2 | 456 / 492 | 24 / 47 | 7,6 | Apache-2.0 | Molte lingue |
| 5 | Tesseract 5.3.4 | 437 / 492 | 33 / 47 | 1,1 | Apache-2.0 | Pagine digitali pulite |
Date lette: Hologlyph, RapidOCR e docTR 457 su 492, EasyOCR 453, Tesseract 441. Le date si fermano a 457 perché è tutto ciò che contiene il livello di testo del PDF: alcuni estratti conto stampano la data una sola volta per un gruppo di movimenti, o scrivono il mese in lettere.
Come abbiamo testato
Gli estratti conto. 47 estratti conto di 47 banche, uno per banca: banche francesi come BNP Paribas, Société Générale, Crédit Agricole e La Banque Postale, banche tedesche e austriache, e le neobanche che un finanziatore incontra davvero (Qonto, Revolut, Wise, bunq, Shine, PayPal, SumUp). 93 pagine in tutto, in francese, tedesco e inglese. Ogni estratto conto è stato anonimizzato prima del test: nomi, indirizzi e numeri di conto sostituiti, layout delle tabelle lasciato invariato.
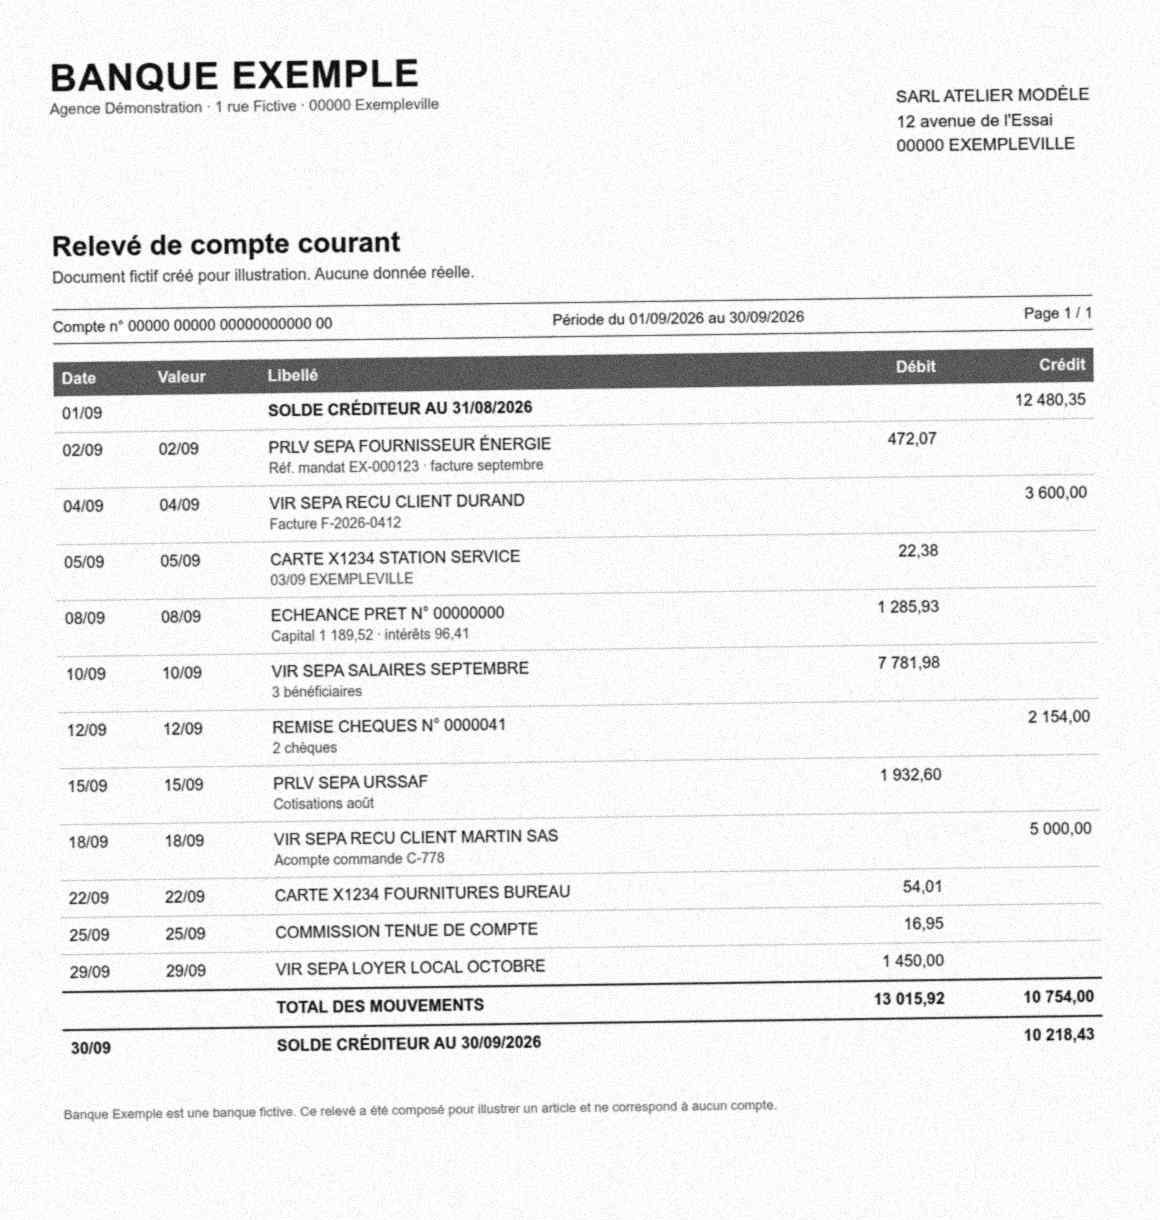
Le scansioni. Ogni pagina è stata renderizzata a 150 dpi in scala di grigi, ruotata di 0,8 gradi, leggermente sfocata, arricchita di rumore del sensore e salvata in JPEG con qualità 35. È ciò che invia per email la fotocopiatrice di una filiale, ed è il motivo per cui esiste l'OCR.
Le risposte. 492 transazioni, ciascuna con data e importo, verificate a mano sul PDF ogni volta che un sistema testato non concordava con il riferimento.
Il punteggio. Per ogni transazione cerchiamo il suo importo in ciò che il motore ha letto su quella pagina, cifra per cifra: 1.234,56, 1 234,56 e 1,234.56 contano tutti, 1234 no, e ogni importo trovato viene usato una sola volta. Una data conta quando sono presenti giorno e mese. Ogni motore è stato eseguito su CPU, con i suoi modelli predefiniti, e valutato dallo stesso codice.
La velocità. Le stesse 10 scansioni, sugli stessi 8 core CPU, un motore alla volta. Hologlyph legge più pagine contemporaneamente; Tesseract per impostazione predefinita legge una pagina alla volta, ed è più veloce se se ne avviano più copie.
1. Hologlyph
Holofin · non open source
491 importi su 492, 46 estratti conto su 47 letti per intero.
Hologlyph è il motore OCR che Holofin sviluppa per i documenti che legge ogni giorno: estratti conto, bilanci, documenti d'identità e le scansioni che li accompagnano.
In questo test ha letto ogni importo presente nel livello di testo del PDF stesso (quello che ha mancato manca anche nel livello di testo), ed è stato il più veloce dei cinque. Un avvertimento onesto: Hologlyph è addestrato su documenti finanziari, quindi i layout di questi 47 estratti conto potrebbero essergli familiari.
Ideale per: Documenti finanziari in cui ogni importo deve essere corretto.
2. RapidOCR 1.4.4
Apache-2.0 · CPU, ONNX Runtime · modelli PP-OCRv4
489 importi su 492, 44 estratti conto su 47 letti per intero.
RapidOCR impacchetta i modelli PP-OCRv4 di Baidu in ONNX, quindi si installa con pip e funziona su CPU senza framework di deep learning. Legge intere righe in una volta, il che funziona bene sui numeri. Il prezzo si paga sulle parole: sul testo latino spesso elimina gli spazi, quindi RELEVE DE VOTRE COMPTE diventa RELEVEDEVOTRECOMPTE.
Inoltre incolla insieme elementi vicini. Su un estratto conto austriaco ha letto la data di registrazione e l'importo come un'unica stringa, 24.12.202315.000,00EUR. Un parser che la legge come un unico numero ottiene più di duecento milioni di euro.
Ideale per: Pipeline su CPU senza framework di deep learning, dove i numeri contano più delle parole.
3. docTR 1.0.1
Mindee · Apache-2.0 · PyTorch
488 importi su 492, 45 estratti conto su 47 letti per intero.
docTR, di Mindee, legge in due fasi: un rilevatore trova le parole, un riconoscitore le legge. Restituisce riquadri delle parole puliti con le loro posizioni, il che lo rende il più semplice dei cinque su cui costruire un parser di tabelle. Richiede PyTorch, e ha letto per intero un estratto conto in più rispetto a RapidOCR, mancando però un importo in più.
Ideale per: Team che vogliono le posizioni delle parole e un'API Python su cui fare fine-tuning.
4. EasyOCR 1.7.2
JaidedAI · Apache-2.0 · PyTorch
456 importi su 492, 24 estratti conto su 47 letti per intero.
EasyOCR è il più semplice da installare e legge più di 80 lingue. Sugli estratti conto scansionati ha letto la maggior parte degli importi ma ha storpiato i decimali: 7.781,98 è diventato 7.78/,98, 50.000,00 è diventato 50.000,oo/ e 25.000,00 è diventato 25,00o 0o. In una frase, uno zero letto come la lettera o è un refuso. In una colonna di importi è una transazione che non si riesce più ad analizzare. È stato anche il più lento dei cinque.
Ideale per: Testo multilingue in cui qualche errore di carattere è accettabile. Non gli importi.
5. Tesseract 5.3.4
Apache-2.0 · C++ · funziona ovunque
437 importi su 492, 33 estratti conto su 47 letti per intero.
Tesseract è la risposta predefinita a "OCR gratuito". Su queste scansioni ha mancato 1 importo su 9. Peggio delle mancate letture sono le letture errate: 472,07 è tornato come 47207 e 22,38 come 2236. Entrambi sembrano importi reali. Un numero mancante fa fallire un saldo in modo evidente. Un numero sbagliato lo fa fallire in silenzio.
Ideale per: Pagine pulite nate in digitale e testo che verrà riletto. Non documenti finanziari scansionati.
Cosa non dice un tasso di lettura
Leggere non è estrarre
Un motore che legge ogni importo non Le ha ancora detto quale importo è l'addebito, quale l'accredito e quale il saldo progressivo. I layout degli estratti conto mettono le date su una riga e gli importi su quella successiva, spezzano le descrizioni su tre righe e ripetono l'intestazione su ogni pagina. Trasformare il testo in transazioni è un lavoro a parte, ed è da lì che nasce la maggior parte degli errori di estrazione.
Un importo sbagliato sembra giusto
Ogni lettura errata qui sopra è un numero valido. 47207 supera ogni controllo di formato che un foglio di calcolo eseguirà. L'unica cosa che lo intercetta è l'aritmetica: il saldo iniziale più le transazioni deve essere uguale al saldo finale. Se la Sua pipeline non fa questa somma, non sa se il suo OCR ha funzionato.
L'OCR legge altrettanto bene un estratto conto falsificato
Un OCR perfetto legge un estratto conto modificato con la stessa fedeltà di uno autentico. Se il PDF sia stato modificato dopo che la banca lo ha prodotto, o se una pagina sia stata ridisegnata da un modello di immagini, è una domanda che l'OCR non si pone.
Come scegliere un OCR per documenti finanziari
- Testi sulle Sue scansioni, non su PDF puliti: è sulle scansioni che i motori si differenziano.
- Conti gli importi, non i caratteri. Un'accuratezza del 99% sui caratteri nasconde l'unico carattere che sposta una virgola decimale.
- Verifichi se raddrizza la pagina. Una fotocopiatrice ruota le pagine di circa un grado, e una riga inclinata mette l'importo sulla riga sbagliata.
- Mantenga i numeri interi. Un motore che spezza
15 000,00tra i suoi gruppi, o lo incolla alla data accanto, consegna al Suo parser un numero diverso. - Riconcili dopo la lettura. Saldo iniziale più transazioni uguale saldo finale, altrimenti l'estratto conto passa a una persona.
In Holofin, leggere la pagina è il primo passo, non il prodotto. Ogni estratto conto viene letto, trasformato in transazioni e riconciliato: il saldo iniziale più le transazioni deve essere uguale al saldo finale entro 0,02 EUR. Ogni PDF passa attraverso più di 100 controlli antifrode forensi, i documenti restano nell'UE, e il costo parte da 0,05 EUR a pagina.
Fonti
- RapidOCR 1.4.4
- docTR 1.0.1
- EasyOCR 1.7.2
- Tesseract 5.3.4
- PaddleOCR (PP-OCRv4)
- Benchmark di estrazione degli estratti conto
Ha notato un errore? Scriva a [email protected] e ripeteremo il test annotando la modifica.
Domande frequenti
Qual è il miglior OCR per gli estratti conto?
Nel nostro test, Hologlyph ha letto 491 importi su 492 su 47 estratti conto scansionati. Tra i motori open source, RapidOCR (489) e docTR (488) seguivano da vicino, ben davanti a EasyOCR (456) e Tesseract (437).
Qual è il miglior OCR open source per gli estratti conto?
RapidOCR e docTR, entrambi Apache-2.0. RapidOCR ha letto 489 importi su 492 e non richiede alcun framework di deep learning; docTR ne ha letti 488, ha letto per intero 45 estratti conto su 47 ed è stato due volte più veloce nel nostro test su CPU.
Tesseract vs EasyOCR vs docTR: quale legge meglio gli estratti conto?
docTR, con ampio margine: 488 importi contro 456 per EasyOCR e 437 per Tesseract, e 45 estratti conto letti per intero contro 24 e 33. Tesseract è stato il più veloce dei tre, con 1,1 secondi a pagina.
Tesseract è sufficiente per i documenti finanziari?
Per gli estratti conto scansionati, no. Ha mancato 55 importi su 492 e ne ha trasformati alcuni in numeri diversi dall'aspetto valido, come 47207 per 472,07.
Quanto è accurato l'OCR sugli estratti conto scansionati?
Sulle nostre scansioni, i cinque motori hanno letto tra l'88,8% e il 99,8% degli importi. Anche il 99% da solo non basta: un importo letto male in un estratto conto trimestrale significa che i saldi non tornano più.
Serve una GPU per l'OCR?
No. Tutti e cinque i motori di questo test sono stati eseguiti su CPU, e RapidOCR non richiede alcun framework di deep learning.
Hologlyph è open source?
No. È il motore OCR che Holofin sviluppa per i documenti che elabora.
Come si richiede la correzione di un risultato?
Scriva a [email protected] indicando il motore, la sua versione e cosa ha misurato. Ripetiamo il test, correggiamo la riga e aggiorniamo la data.
Provi Holofin sui Suoi documenti.
Ogni valore collegato alla pagina da cui proviene, ogni PDF controllato contro le manomissioni, regole verificate sull'intera pratica.