
Une analyste crédit ouvre un dossier de prêt à six heures du soir. Dedans : un Kbis, trois mois de relevés bancaires et une liasse fiscale, la 2033 d'une petite société qui veut acheter une deuxième camionnette de livraison. L'extraction a tourné il y a une heure. Toutes les cases de la 2033-A sont remplies, le score de confiance est au vert, et le chiffre d'affaires de la 2033-B paraît plausible pour une entreprise de quatre salariés.
Puis, par habitude, elle refait à la main la somme des immobilisations et tombe sur un chiffre à 5 000 euros du total imprimé en bas de la colonne.
Personne n'a menti. Un 3 a été lu comme un 8 à la ligne 028. Le modèle était sûr de lui, parce qu'un 3 et un 8 sont deux chiffres parfaitement valables. Mais le formulaire, lui, savait. La réponse était imprimée sur la même page, onze lignes plus bas, et rien dans le pipeline d'extraction ne l'a vérifiée.
Un formulaire fiscal livré avec son corrigé
La plupart des documents que nous extrayons n'offrent rien pour se vérifier. Un bulletin de paie a un net à payer et quelques cotisations qui tombent juste, parfois, si l'on connaît la convention collective. Un relevé bancaire affiche un solde après chaque opération, quand la banque prend la peine de l'imprimer.
La liasse fiscale est différente. C'est un ensemble de formulaires que l'administration a conçus pour pouvoir les contrôler. Chaque section se termine par un total. Chaque total a un code de case. Chaque résultat est une soustraction que l'on peut refaire. Au régime simplifié, la 2033-A imprime même l'actif et le passif sur la même page : le total de l'actif doit égaler celui du passif, pour l'exercice N comme pour N-1, dans le même document.
C'est le document financier le plus facile à vérifier pour un pipeline d'extraction, et presque personne n'en profite. Un pipeline classique lit chaque case, lui attribue un score et passe à la suivante. Les totaux sont extraits comme n'importe quel autre champ : un nombre de plus, avec un score de confiance de plus.
Un total n'est pas un champ. C'est un test.
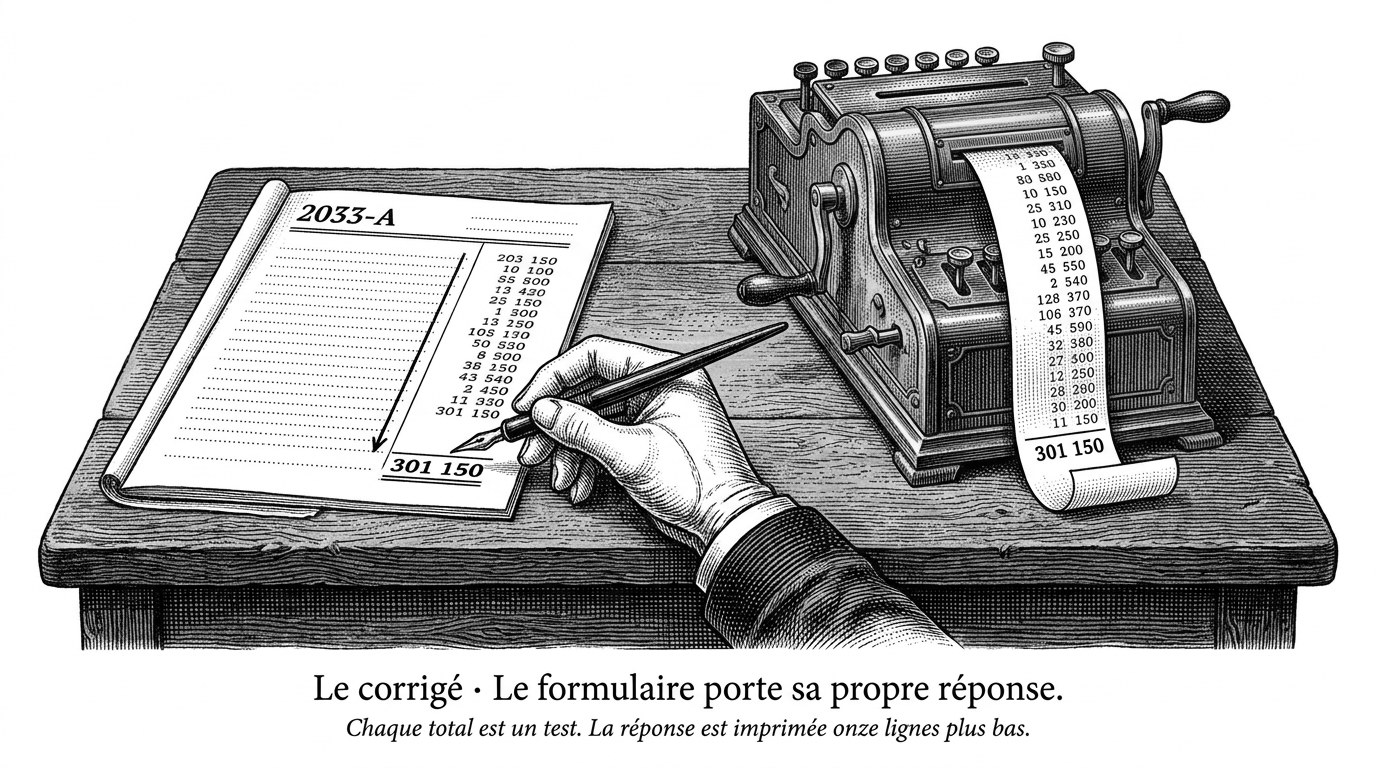
Alors nous avons transformé les formulaires en tests. Sur les millésimes 2026, nous exécutons 133 contrôles de cohérence sur 17 formulaires : 98 au régime normal (2050 à 2059) et 35 au régime simplifié (2033-A à G). La 2055, le tableau des amortissements, en porte 42 à elle seule, parce que chaque colonne de chaque cadre a son total et que chaque cadre justifie le passage du solde d'ouverture au solde de clôture.
Au régime réel normal, la liasse 2050 :
| Formulaire | Intitulé | Contrôles |
|---|---|---|
| CERFA 2050 | Bilan actif | 4 |
| CERFA 2051 | Bilan passif | 5 |
| CERFA 2052 | Compte de résultat de l'exercice | 7 |
| CERFA 2053 | Compte de résultat de l'exercice (suite) | 1 |
| CERFA 2054 | Immobilisations | 7 |
| CERFA 2055 | Amortissements | 42 |
| CERFA 2056 | Provisions inscrites au bilan | 16 |
| CERFA 2057 | État des échéances des créances et des dettes | 9 |
| CERFA 2058-C | Affectation du résultat et renseignements divers | 3 |
| CERFA 2059-F | Composition du capital social | 4 |
Au régime simplifié, la liasse 2033 :
| Formulaire | Intitulé | Contrôles |
|---|---|---|
| CERFA 2033-A | Bilan simplifié | 7 |
| CERFA 2033-B | Compte de résultat simplifié | 8 |
| CERFA 2033-C | Immobilisations, amortissements, plus et moins-values | 4 |
| CERFA 2033-D | Relevé des provisions, amortissements dérogatoires, déficits reportables | 7 |
| CERFA 2033-E | Détermination des effectifs et de la valeur ajoutée | 4 |
| CERFA 2033-F | Composition du capital social | 4 |
| CERFA 2033-G | Filiales et participations | 1 |
Un contrôle n'a rien de sophistiqué. C'est la formule imprimée dans la notice, écrite une fois pour toutes :
# 2052, compte de résultat
GG = FR - GF            # résultat d'exploitation = produits - charges
GV = GP - GU            # résultat financier
GW = GG + GV            # résultat courant avant impôts

# 2033-A, bilan simplifié
110_net_n  = 180        # total actif = total passif, exercice N
110_net_n1 = 180_n1     # et encore pour N-1
Quand un contrôle échoue, nous savons quelle case est suspecte, et à peu près de combien elle se trompe. Un écart d'exactement 5 000 euros à côté d'une ligne qui contient un 3, c'est une erreur vite élucidée.
Un euro par montant
Notre première version comparait chaque total à la somme de ses lignes avec une tolérance fixe de 10 euros. Cela semblait généreux : une erreur de lecture se compte rarement en moins de dix euros.
Puis une 2033-A est arrivée où l'actif de l'exercice précédent ratait de 11 euros. L'extraction était parfaite. Chaque chiffre correspondait à la page.
C'était la page elle-même qui était « fausse », et d'une façon prévisible. Les logiciels comptables calculent les montants au centime près et les impriment arrondis à l'euro. Chaque ligne imprimée porte jusqu'à un euro d'arrondi. Le total est calculé à partir des centimes, puis arrondi une seule fois. L'écart entre un total imprimé et la somme de ses lignes imprimées peut donc atteindre un euro par montant de la formule. Certains logiciels tronquent au lieu d'arrondir, et les erreurs de troncature vont toutes dans le même sens au lieu de se compenser : elles atteignent vraiment cette borne. Dix-neuf lignes non nulles peuvent légitimement s'écarter de 19 euros.
La tolérance est désormais exactement celle-là :
tolérance = max(10, nombre de montants non nuls de la formule, total compris)
Les lignes vides ou à zéro ne portent aucun arrondi, elles ne comptent pas. Un total de trois lignes garde 10 euros. Un total de dix-neuf lignes en reçoit 19. La marge vient de la façon dont le document a été imprimé, pas de la confiance que nous accordons au modèle d'extraction.
Et là où le formulaire contient des effectifs plutôt que des montants (le nombre de filiales sur la 2033-F, par exemple), la tolérance est nulle. Personne n'arrondit un effectif.
Même formulaire, quatre millésimes
Une 2050 n'est pas une 2050. L'administration révise les formulaires chaque année : une ligne apparaît, deux cases fusionnent, un code change de place. Une liasse clôturée en 2023 et une autre clôturée en 2026 partagent un nom, un numéro CERFA et l'essentiel de leur mise en page, et c'est précisément ce qui rend dangereux de les traiter comme un seul formulaire.
Nous tenons un schéma et un jeu de contrôles par millésime, de 2023 à 2026. Les jeux de contrôles ne sont pas identiques d'une édition à l'autre. La 2033-F et la 2059-F n'ont gagné des contrôles que dans les éditions récentes, parce que les cases nécessaires n'existaient pas avant.
Cela permet aussi de détecter une anomalie qui n'a rien à voir avec l'extraction. Une liasse imprimée sur le formulaire 2026 pour un exercice clos en 2023 est soit une réédition, soit un vieux fichier déguisé en neuf. L'édition du formulaire et la date de clôture doivent concorder.
Une case non lue ne vaut pas zéro
Voici l'erreur que nous avons faite, et que la plupart des pipelines font encore. Une case est vide. L'extracteur renvoie null. Le contrôle remplace par zéro, fait l'addition et échoue, ou pire, réussit, parce que la case vide valait vraiment zéro sur la page.
Les deux résultats sont des mensonges. Une case vide et une case non lue sont deux faits différents. Une petite société qui ne vend que des services laisse vides les lignes « ventes de marchandises » et remplit à la place l'agrégat « chiffre d'affaires net ». Additionner les lignes de détail vides et les comparer à l'agrégat produit une fausse alerte sur un formulaire parfaitement honnête.
Un contrôle à qui il manque ses entrées ne s'exécute donc pas. Il enregistre qu'il a été ignoré, et pourquoi. Quand le formulaire propose un agrégat à la place de ses lignes de détail, le contrôle se rabat sur l'agrégat. Un contrôle qui n'a pas tourné n'est pas un contrôle réussi. Le rapport le dit, et la personne qui relit voit la différence entre « 13 sommes sur 13 sont justes » et « 9 sommes sont justes, 4 n'ont pas pu être testées ».
Une liasse équilibrée valide l'extraction, pas l'entreprise
Vient maintenant la partie inconfortable, celle qui compte si vous prêtez de l'argent.
Les contrôles arithmétiques détectent les erreurs de lecture. Ils détectent rarement les fraudes. Le fraudeur qui ouvre un éditeur PDF et retape le résultat net d'une 2033-A, sans toucher au reste, fausse le total du passif et échoue au contrôle d'équilibre sur la même page. Ce fraudeur existe, et il est plus courant qu'on ne l'espérerait.
Mais quiconque génère une fausse liasse depuis un logiciel comptable (et le logiciel ne coûte pas cher) obtient un document équilibré à l'euro près. Nos 133 contrôles passent tous. L'arithmétique est impeccable, parce qu'une machine l'a faite.
L'équilibre comptable est donc un prérequis, pas une garantie. Elles disent que ce que nous avons extrait est bien ce qui figure sur la page. Savoir si ce qui figure sur la page est vrai demande d'autres preuves :
- Le registre. Le SIREN de la liasse doit exister, être actif, et porter la même dénomination et le même siège.
- Le reste du dossier. Le SIREN doit correspondre au Kbis. Le chiffre d'affaires déclaré doit être du même ordre que ce qui arrive réellement sur le compte bancaire professionnel.
- Le fichier lui-même. Un montant retapé laisse souvent l'original en dessous.
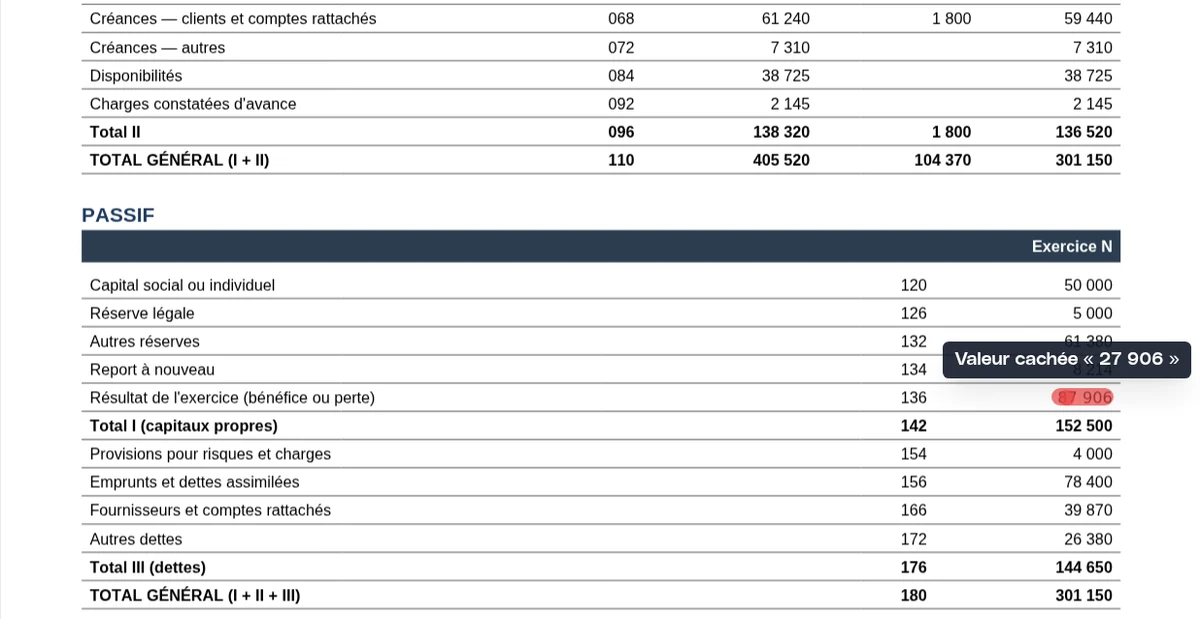
Dans l'exemple ci-dessus, l'arithmétique et l'analyse du fichier racontent la même histoire par deux côtés. C'est sur cet accord qu'un verdict doit reposer. Une colonne d'additions propre n'y suffit pas.
Notre approche chez Holofin
Lire des documents financiers, c'est notre métier, et c'est avec la liasse que nous avons appris à ne plus traiter les totaux comme des données.
Quelques principes en sont sortis :
- L'arithmétique du document passe en premier. Si un formulaire imprime ses totaux, l'extraction n'est pas terminée tant que les totaux ne sont pas justes. La confiance d'un modèle est au mieux un second avis.
- La tolérance a une raison. Un euro par montant imprimé, parce que c'est ainsi que les logiciels comptables arrondissent. Zéro pour les effectifs. Jamais un chiffre choisi pour faire passer un test au vert.
- Non testé est un résultat en soi. Un contrôle privé de ses entrées le dit, au lieu de se cacher dans un taux de réussite.
- Équilibré ne veut pas dire authentique. Les sommes valident la lecture. Les données du registre, les autres pièces du dossier et l'historique du fichier valident l'entreprise.
Chaque contrôle porte sa formule, les valeurs utilisées, l'écart et la tolérance appliquée, pour que l'analyste de six heures du soir voie pourquoi un total a échoué, et pas seulement qu'il a échoué. Les contrôles de chaque formulaire sont publiés avec l'API, parce qu'une règle qu'un client ne peut pas lire est une règle à laquelle il ne peut pas se fier.
Pour finir
La liasse fiscale est l'un des rares documents qui arrivent avec leur propre corrigé. L'administration l'a rédigé, l'a imprimé sur chaque page, et ne demande rien en retour, sinon que quelqu'un le lise.
La plupart des pipelines extraient les réponses sans jamais les confronter aux questions. Lisez les totaux comme des tests, et le formulaire vous dira où il a été mal lu. Puis souvenez-vous qu'un fraudeur peut réussir le même test, et allez chercher les preuves qu'une calculatrice ne sait pas fabriquer.
Articles connexes
Holograin : Détecter les documents redessinés par l'IA
Holograin est notre détecteur pour les documents numérisés et les photos redessinés par un générateur d'images IA. Il détecte 90 % des pages modifiées par l'IA après téléchargement tout en signalant 1 page authentique sur 100. Voici comment il se compare aux LLMs de pointe et aux détecteurs d'images IA open source.
Un deepfake peut avoir l'air vrai. Encore faut-il qu'il le soit.
Un faussaire peut effacer toute trace de la création d'un document : l'imprimer, le numériser à nouveau, le régénérer avec un modèle d'image. Ce que le document affirme survit à ce lavage, et une affirmation peut être vérifiée. Voici comment nous vérifions ces affirmations, là où nos propres contrôles nous ont d'abord fait défaut, et les deux indicateurs qui garantissent notre intégrité.
Forest et la nécessité de traiter la décision comme une infrastructure, pas comme une boîte de réception
Forest a fait valoir que l'OCR mérite d'être traité comme une infrastructure plutôt que comme une commodité. Voici l'argument complémentaire vu de l'amont : la couche qui reçoit les données mérite le même sérieux, car un chiffre parfaitement extrait peut toujours attendre trois jours, être approuvé par la mauvaise personne et ne laisser aucune trace de ce qui s'est passé.